import pandas as pd
import numpy as np
import sqlite3
import statsmodels.formula.api as smf
import statsmodels.api as sm
from pandas.tseries.offsets import MonthEnd

# Connect to the Vietnamese data
tidy_finance = sqlite3.connect(database="data/tidy_finance_python.sqlite")

# Load Monthly Prices (HOSE & HNX)
prices_monthly = pd.read_sql_query(
  sql="SELECT symbol, date, ret_excess, mktcap, mktcap_lag FROM prices_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)

# Load Book Equity (derived from Vietnamese Financial Statements)
comp_vn = pd.read_sql_query(
  sql="SELECT datadate, symbol, be FROM comp_vn",
  con=tidy_finance,
  parse_dates={"datadate"}
)

# Load Rolling Market Betas (Pre-calculated in Chapter 'Beta Estimation')
beta_monthly = pd.read_sql_query(
  sql="SELECT symbol, date, beta FROM beta_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)20 Hồi quy Fama-MacBeth
Trong chương này, chúng ta triển khai phương pháp hồi quy của Fama và MacBeth (1973), một nền tảng cốt lõi của định giá tài sản thực nghiệm. Trong khi phân loại danh mục cung cấp một cách nhìn vững chắc, phi tham số về mối quan hệ giữa các đặc điểm và lợi nhuận, phương pháp này gặp khó khăn khi chúng ta cần kiểm soát đồng thời nhiều nhân tố. Chẳng hạn, trên thị trường chứng khoán Việt Nam (HOSE và HNX), các cổ phiếu vốn hóa nhỏ thường có mức phi thanh khoản cao. Liệu “hiệu ứng quy mô” tồn tại vì cổ phiếu nhỏ có rủi ro cao, hay đơn giản chỉ vì chúng kém thanh khoản? Hồi quy Fama-MacBeth (FM) cho phép chúng ta tách bạch các tác động này trong một khung tuyến tính.
Chúng ta sẽ triển khai một phiên bản của thủ tục FM, có tính đến:
- Bình phương tối thiểu có trọng số (WLS): Nhằm ngăn các cổ phiếu vốn hóa siêu nhỏ, vốn phổ biến và biến động mạnh ở Việt Nam, chi phối các ước lượng.
- Điều chỉnh Newey-West: Nhằm xử lý tương quan chuỗi thường quan sát được ở các phần bù rủi ro của thị trường Việt Nam.
20.1 Khung kinh tế lượng
Thủ tục Fama-MacBeth về bản chất là một bộ lọc hai bước, tách biến thiên chéo (cross-section) của lợi nhuận khỏi biến thiên theo chuỗi thời gian.
20.1.1 Trực giác: Vì sao không dùng OLS dữ liệu bảng?
Một cách tiếp cận ngây thơ là gộp toàn bộ dữ liệu (\(N\) cổ phiếu \(\times\) \(T\) tháng) và chạy một hồi quy bình phương tối thiểu thông thường (OLS) duy nhất:
\[ r_{i,t+1} = \alpha + \beta_{i,t} \lambda + \epsilon_{i,t+1} \]
Tuy nhiên, cách làm này giả định rằng các số hạng sai số \(\epsilon_{i,t+1}\) độc lập giữa các doanh nghiệp. Trên thực tế, lợi nhuận cổ phiếu có tương quan chéo rất cao (nếu VN-Index sụp đổ, hầu hết cổ phiếu cùng giảm). OLS gộp sẽ đánh giá thấp sai số chuẩn, dẫn đến các phát hiện “dương tính giả” về các nhân tố rủi ro. Fama-MacBeth giải quyết vấn đề này bằng cách chạy \(T\) hồi quy chéo riêng biệt, qua đó coi mỗi tháng như một quan sát độc lập duy nhất về phần bù rủi ro.
20.1.2 Suy diễn toán học
20.1.2.1 Bước 1: Hồi quy chéo
Với mỗi tháng \(t\), chúng ta ước lượng phần bù \(\lambda_{k,t}\) cho \(K\) nhân tố. Gọi \(r_{i,t+1}\) là lợi nhuận vượt mức của tài sản \(i\) tại thời điểm \(t+1\). Gọi \(\boldsymbol{\beta}_{i,t}\) là vector gồm \(K\) đặc điểm (ví dụ: beta thị trường, tỷ số giá trị sổ sách trên giá trị thị trường, quy mô) đã biết tại thời điểm \(t\).
Mô hình cho một tháng \(t\) cụ thể là: \[ \mathbf{r}_{t+1} = \mathbf{X}_t \boldsymbol{\lambda}_{t+1} + \boldsymbol{\alpha}_{t+1} + \boldsymbol{\epsilon}_{t+1} \]
Trong đó:
- \(\mathbf{r}_{t+1}\) là vector \(N \times 1\) các lợi nhuận.
- \(\mathbf{X}_t\) là ma trận \(N \times (K+1)\) các mức độ phơi nhiễm nhân tố (bao gồm một cột toàn số một cho hệ số chặn).
- \(\boldsymbol{\lambda}_{t+1}\) là vector các phần bù rủi ro thực hiện trong tháng \(t+1\).
Để dùng bình phương tối thiểu có trọng số (WLS), chúng ta định nghĩa một ma trận trọng số \(\mathbf{W}_t\) (thường là ma trận đường chéo chứa vốn hóa thị trường). Ước lượng cho tháng \(t\) là: \[ \hat{\boldsymbol{\lambda}}_{t+1} = (\mathbf{X}_t^\top \mathbf{W}_t \mathbf{X}_t)^{-1} \mathbf{X}_t^\top \mathbf{W}_t \mathbf{r}_{t+1} \]
20.1.2.2 Bước 2: Tổng hợp theo chuỗi thời gian
Bây giờ chúng ta có một chuỗi thời gian gồm \(T\) ước lượng: \(\hat{\lambda}_1, \hat{\lambda}_2, \dots, \hat{\lambda}_T\). Ước lượng cuối cùng của phần bù rủi ro là trung bình theo chuỗi thời gian: \[ \hat{\lambda}_k = \frac{1}{T} \sum_{t=1}^T \hat{\lambda}_{k,t} \]
Sai số chuẩn được suy ra từ độ lệch chuẩn của các ước lượng hằng tháng này: \[ \sigma(\hat{\lambda}_k) = \sqrt{\frac{1}{T^2} \sum_{t=1}^T (\hat{\lambda}_{k,t} - \hat{\lambda}_k)^2} \]
20.2 Chuẩn bị dữ liệu
Chúng ta sử dụng dữ liệu từ cơ sở dữ liệu SQLite cục bộ. Ở Việt Nam, năm tài chính thường kết thúc vào tháng 12 và báo cáo đã kiểm toán phải được nộp chậm nhất trong tháng 4. Để bảo đảm không có thiên lệch nhìn trước, chúng ta làm trễ dữ liệu kế toán (vốn chủ sở hữu sổ sách) để khớp với lợi nhuận bắt đầu từ tháng 7 (độ trễ thận trọng 6 tháng, tương tự Fama-French nhưng điều chỉnh theo độ trễ công bố thông tin của Việt Nam).
Chúng ta xây dựng các đặc điểm dùng để kiểm định:
- (Beta thị trường): Độ nhạy đối với VN-Index.
- Quy mô (ln(ME)): Logarit tự nhiên của vốn hóa thị trường.
- Giá trị (BM): Tỷ số giữa giá trị sổ sách của vốn chủ sở hữu và giá trị thị trường của vốn chủ sở hữu.
# Prepare Characteristics
characteristics = (
    comp_vn
    # Align reporting date to month end
    .assign(date=lambda x: pd.to_datetime(x["datadate"]) + MonthEnd(0))
    # Merge with price data to get Market Cap at fiscal year end
    .merge(prices_monthly, on=["symbol", "date"], how="left")
    .merge(beta_monthly, on=["symbol", "date"], how="left")
    .assign(
        # Compute Book-to-Market
        bm=lambda x: x["be"] / x["mktcap"],
        log_mktcap=lambda x: np.log(x["mktcap"]),
        # Create sorting date: Financials valid from July of year t+1
        sorting_date=lambda x: x["date"] + pd.DateOffset(months=6) + MonthEnd(0),
    )
    .get(["symbol", "bm", "beta", "sorting_date"])
    .dropna()
)

characteristics.head()| symbol | bm | beta | sorting_date | |
|---|---|---|---|---|
| 8729 | VTV | 7.034945e+08 | 0.847809 | 2017-06-30 |
| 8732 | MTG | 2.670306e+09 | 1.140066 | 2017-06-30 |
| 8739 | MKV | 6.505031e+08 | -0.448319 | 2017-06-30 |
| 8740 | MIC | 1.243127e+09 | 0.772140 | 2017-06-30 |
| 8742 | MCP | 6.657350e+08 | 0.348139 | 2017-06-30 |
# Merge back to monthly return panel
data_fm = (prices_monthly
  .merge(characteristics,
         left_on=["symbol", "date"],
         right_on=["symbol", "sorting_date"],
         how="left")
#   .merge(beta_monthly, on=["symbol", "date"], how="left")
  .sort_values(["symbol", "date"])
)

# Forward fill characteristics for 12 months (valid until next report)
data_fm[["bm"]] = data_fm.groupby("symbol")[["bm"]].ffill(limit=12)

# Log Market Cap is updated monthly
data_fm["log_mktcap"] = np.log(data_fm["mktcap"])

# Lead returns: We use characteristics at t to predict return at t+1
data_fm["ret_excess_lead"] = data_fm.groupby("symbol")["ret_excess"].shift(-1)

# Cleaning: Remove rows with missing future returns or characteristics
data_fm = data_fm.dropna(subset=["ret_excess_lead", "beta", "log_mktcap", "bm"])

print(data_fm.head())

print(f"Data ready: {len(data_fm):,} observations from {data_fm.date.min().date()} to {data_fm.date.max().date()}")
symbol date ret_excess mktcap mktcap_lag bm \
163 AAA 2017-06-30 0.129454 2078.455619 1834.816104 7.929854e+08
175 AAA 2018-06-30 -0.067690 2758.426126 2948.159140 8.161755e+08
187 AAA 2019-06-30 0.030469 3141.519560 3038.799575 1.389438e+09
199 AAA 2020-06-30 -0.035462 2311.250278 2387.972279 1.497272e+09
211 AAA 2021-06-30 0.275355 5423.280296 4241.283308 1.456989e+09
beta sorting_date log_mktcap ret_excess_lead
163 1.479060 2017-06-30 7.639380 -0.051090
175 1.090411 2018-06-30 7.922416 -0.095926
187 1.099956 2019-06-30 8.052462 -0.027856
199 0.954144 2020-06-30 7.745544 -0.098769
211 1.245004 2021-06-30 8.598456 -0.175128
Data ready: 5,075 observations from 2017-06-30 to 2023-06-3020.3 Bước 1: Hồi quy chéo với WLS
Hou, Xue, và Zhang (2020) lập luận rằng các cổ phiếu vốn hóa siêu nhỏ làm sai lệch suy luận thống kê vì chúng có chi phí giao dịch cao và biến động đặc thù lớn. Ở Việt Nam, tình trạng này càng trầm trọng do hoạt động đầu cơ “cổ phiếu penny”.
Chúng ta triển khai bình phương tối thiểu có trọng số (WLS) với trọng số là vốn hóa thị trường của tháng trước. Cách làm này kiểm tra xem các nhân tố có được định giá trong tập hợp cổ phiếu có thể đầu tư hay không, chứ không chỉ trong mức trung bình trọng số bằng nhau của các cổ phiếu nhỏ.
def run_cross_section(df):
    # Standardize inputs for numerical stability
    # Note: We do NOT standardize the dependent variable (returns)
    # We standardize regressors to interpret coefficients as "per 1 SD change" if desired,
    # BUT for pure risk premium estimation, we usually keep raw units.
    # Here we use raw units to interpret lambda as % return per unit of characteristic.

    # Define Weighted Least Squares
    model = smf.wls(
        formula="ret_excess_lead ~ beta + log_mktcap + bm",
        data=df,
        weights=df["mktcap_lag"] # Weight by size
    )
    results = model.fit()

    return results.params

# Apply to every month
risk_premiums = (data_fm
  .groupby("date")
  .apply(run_cross_section)
  .reset_index()
)

print(risk_premiums.head())
date Intercept beta log_mktcap bm
0 2017-06-30 -0.089116 -0.063799 0.010284 2.897813e-11
1 2018-06-30 -0.023221 -0.008252 0.001890 1.377518e-11
2 2019-06-30 -0.079373 0.035622 0.006224 -8.139910e-12
3 2020-06-30 -0.031213 -0.114968 0.008999 -2.306768e-11
4 2021-06-30 0.081397 -0.011407 -0.007330 -5.211290e-1120.4 Bước 2: Tổng hợp theo chuỗi thời gian và kiểm định giả thuyết
Bây giờ chúng ta đã có chuỗi thời gian của các phần bù rủi ro. Chúng ta tính trung bình số học và các thống kê t.
Điều quan trọng là chúng ta dùng sai số chuẩn Newey-West (HAC). Các phần bù rủi ro ở Việt Nam thường có tự tương quan (động lượng trong hiệu quả của nhân tố). Công thức sai số chuẩn đơn giản sẽ không hợp lệ.
def calculate_fama_macbeth_stats(df, lags=6):
    summary = []

    for col in ["Intercept", "beta", "log_mktcap", "bm"]:
        series = df[col]

        # 1. Point Estimate (Average Risk Premium)
        mean_premium = series.mean()

        # 2. Newey-West Standard Error
        # We regress the series on a constant (ones) to get the SE of the mean
        exog = sm.add_constant(np.ones(len(series)))
        nw_model = sm.OLS(series, exog).fit(
            cov_type='HAC', cov_kwds={'maxlags': lags}
        )

        se = nw_model.bse.iloc[0]
        t_stat = nw_model.tvalues.iloc[0]

        summary.append({
            "Factor": col,
            "Premium (%)": mean_premium * 100,
            "Std Error": se * 100,
            "t-statistic": t_stat,
            "Significance": "*" if abs(t_stat) > 1.96 else ""
        })

    return pd.DataFrame(summary)

price_of_risk = calculate_fama_macbeth_stats(risk_premiums)
print(price_of_risk.round(4))
Factor Premium (%) Std Error t-statistic Significance
0 Intercept -1.8174 1.9117 -0.9507
1 beta -1.7859 1.0407 -1.7161
2 log_mktcap 0.2347 0.2048 1.1457
3 bm -0.0000 0.0000 -0.0928 20.4.1 Trực quan hóa phần bù rủi ro biến thiên theo thời gian
Một ưu điểm lớn của phương pháp FM là chúng ta có thể kiểm tra độ biến động của các phần bù rủi ro theo thời gian. Ở Việt Nam, chúng ta kỳ vọng phần bù “quy mô” biến động rất mạnh trong các giai đoạn dòng tiền nhỏ lẻ đổ vào thị trường (ví dụ: 2020-2021).
import matplotlib.pyplot as plt
import matplotlib.ticker as mtick

# Calculate cumulative returns of the factors (as if they were tradable portfolios)
cumulative_premiums = (risk_premiums
    .set_index("date")
    .drop(columns=["Intercept"])
    .cumsum()
)

fig, ax = plt.subplots(figsize=(10, 6))
cumulative_premiums.plot(ax=ax, linewidth=2)
ax.set_title("Cumulative Risk Premiums in Vietnam (Fama-MacBeth)", fontsize=14)
ax.set_ylabel("Cumulative Coefficient Return")
ax.legend(title="Factor")
ax.grid(True, alpha=0.3)
plt.show()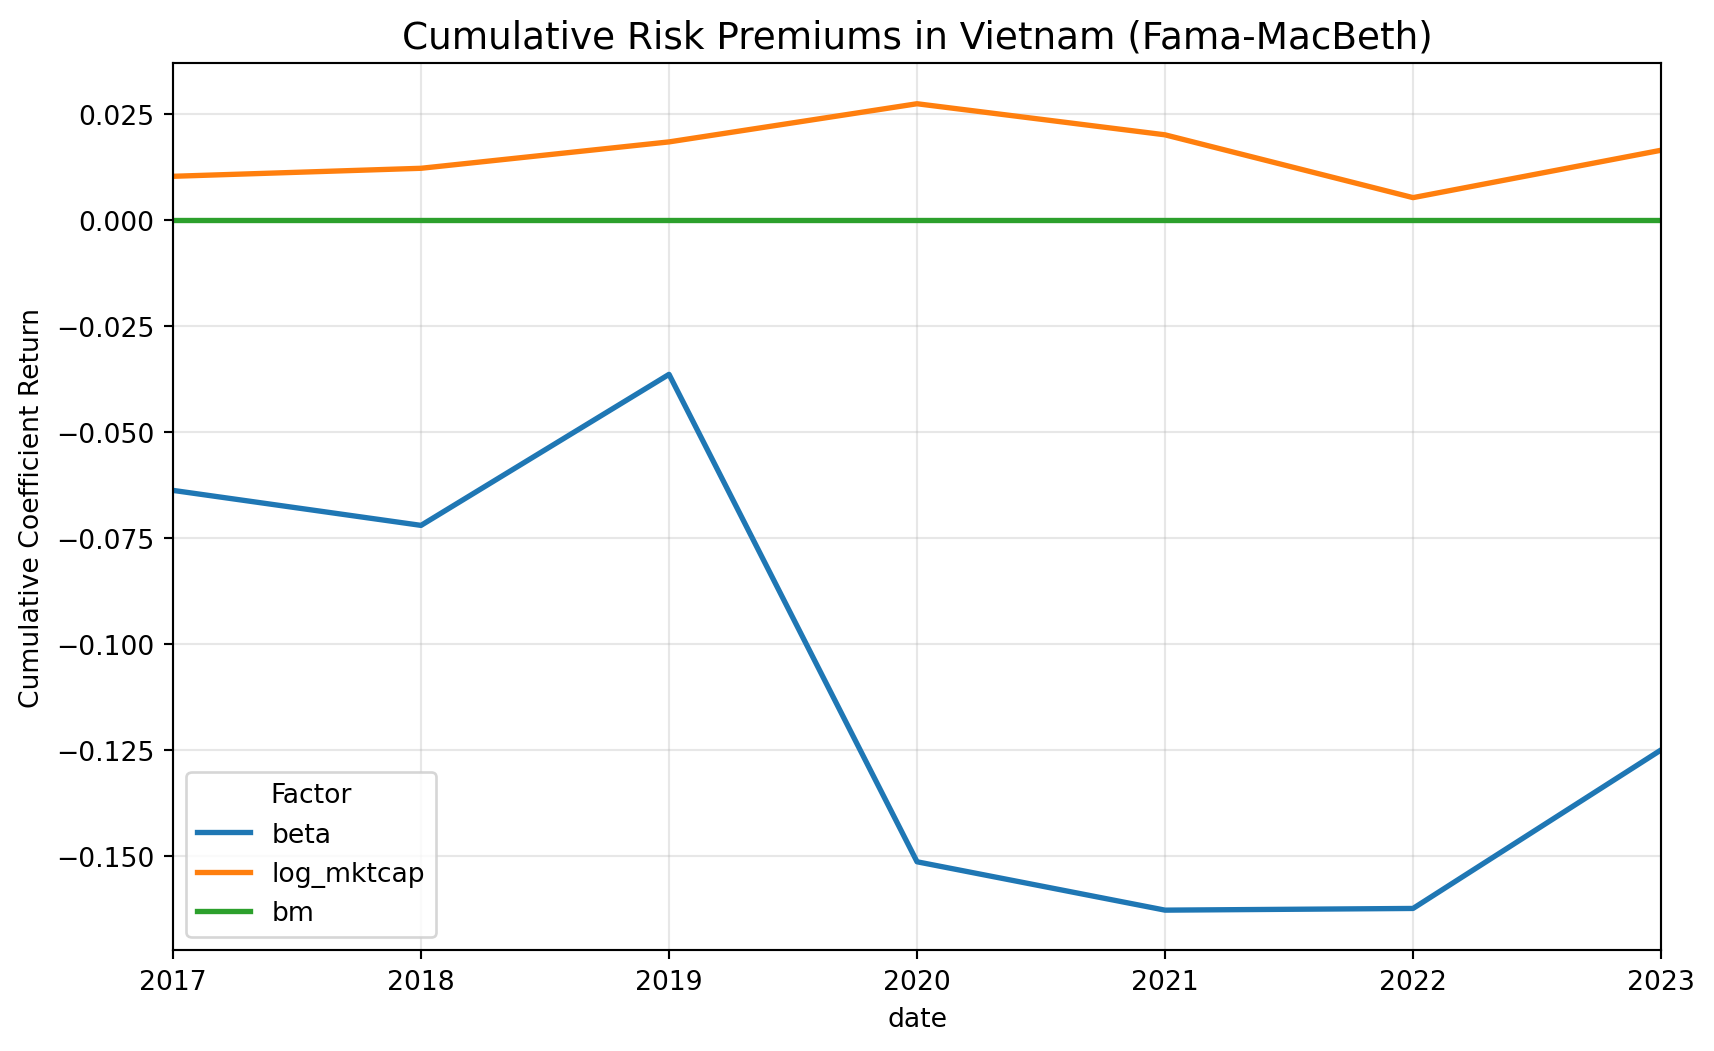
- Beta thị trường: Trong nhiều nghiên cứu thực nghiệm (kể cả ở Mỹ), phần bù beta thị trường thường không có ý nghĩa thống kê hoặc thậm chí âm (hiện tượng bất thường “Betting Against Beta”). Ở Việt Nam, nếu thống kê t không có ý nghĩa thống kê, điều đó hàm ý CAPM không giải thích được mặt cắt ngang của lợi nhuận.
- Quy mô (Log Mktcap): Hệ số âm xác nhận “hiệu ứng quy mô”—các doanh nghiệp nhỏ hơn có lợi nhuận kỳ vọng cao hơn. Tuy nhiên, việc dùng WLS thường làm yếu kết quả này so với OLS, cho thấy phần bù quy mô tập trung ở các cổ phiếu vốn hóa siêu nhỏ.
- Giá trị (BM): Hệ số dương xác nhận phần bù giá trị. Ở Việt Nam, cổ phiếu giá trị (B/M cao) thường vượt trội cổ phiếu tăng trưởng, đặc biệt trong các ngành sản xuất và ngân hàng.
Hình 20.1 vẽ tổng tích lũy của các ước lượng phần bù rủi ro Fama MacBeth hằng tháng cho beta, quy mô và giá trị. Vì các đường này tích lũy các mức giá rủi ro ước lượng từ mặt cắt ngang chứ không phải lợi nhuận danh mục thực tế, nên hình cần được diễn giải là thể hiện sự biến thiên theo thời gian và tính bền vững của các phần bù ước lượng, chứ không phải hiệu quả đầu tư có thể thực hiện.
Phần bù beta cho thấy một sự chuyển chế độ rõ rệt quanh năm 2020, với mức giảm mạnh chỉ đảo chiều một phần về sau. Mô thức này gợi ý rằng việc định giá rủi ro hệ thống ở Việt Nam không ổn định trong các mẫu ngắn và có thể chịu ảnh hưởng lớn của các điều kiện thị trường mang tính giai đoạn, chẳng hạn làn sóng giao dịch nhỏ lẻ sau COVID. Phần bù quy mô tương đối mượt hơn nhưng nhỏ về độ lớn, chỉ cho thấy bằng chứng yếu và biến thiên theo thời gian rằng quy mô doanh nghiệp được định giá trong mặt cắt ngang trong giai đoạn này. Phần bù giá trị luôn ở gần mức không, hàm ý rất ít bằng chứng về phần bù nhất quán trong mặt cắt ngang dành cho các doanh nghiệp có B/M cao trong khoảng mẫu này.
Nhìn chung, hình cho thấy các phần bù rủi ro ước lượng trên thị trường Việt Nam biến thiên rất mạnh theo thời gian và nhạy với các chế độ vĩ mô và thị trường cụ thể, củng cố sự cần thiết phải thận trọng khi rút ra kết luận từ các mẫu ngắn.
20.5 Kiểm tra tính hợp lý
20.5.1 Kiểm tra biến động theo chuỗi thời gian
Fama-MacBeth dựa trên giả định rằng phần bù rủi ro thay đổi theo thời gian. Nếu phần bù bm của bạn thực sự gần bằng không trong mọi tháng, phương pháp sẽ thất bại.
Hành động: Vẽ chuỗi thời gian của các hệ số ước lượng. Bạn muốn thấy “nhiễu” quanh một giá trị trung bình. Nếu thấy một đường phẳng hoặc một đỉnh nhọn khổng lồ duy nhất, dữ liệu của bạn đã bị hỏng.
import matplotlib.pyplot as plt

# Plot the time series of the BM risk premium
fig, ax = plt.subplots(figsize=(10, 5))
risk_premiums["bm"].plot(ax=ax, title="Monthly Value Premium (BM) Coefficient")
ax.axhline(0, color="black", linestyle="--")
ax.set_ylabel("Slope Coefficient")
plt.show()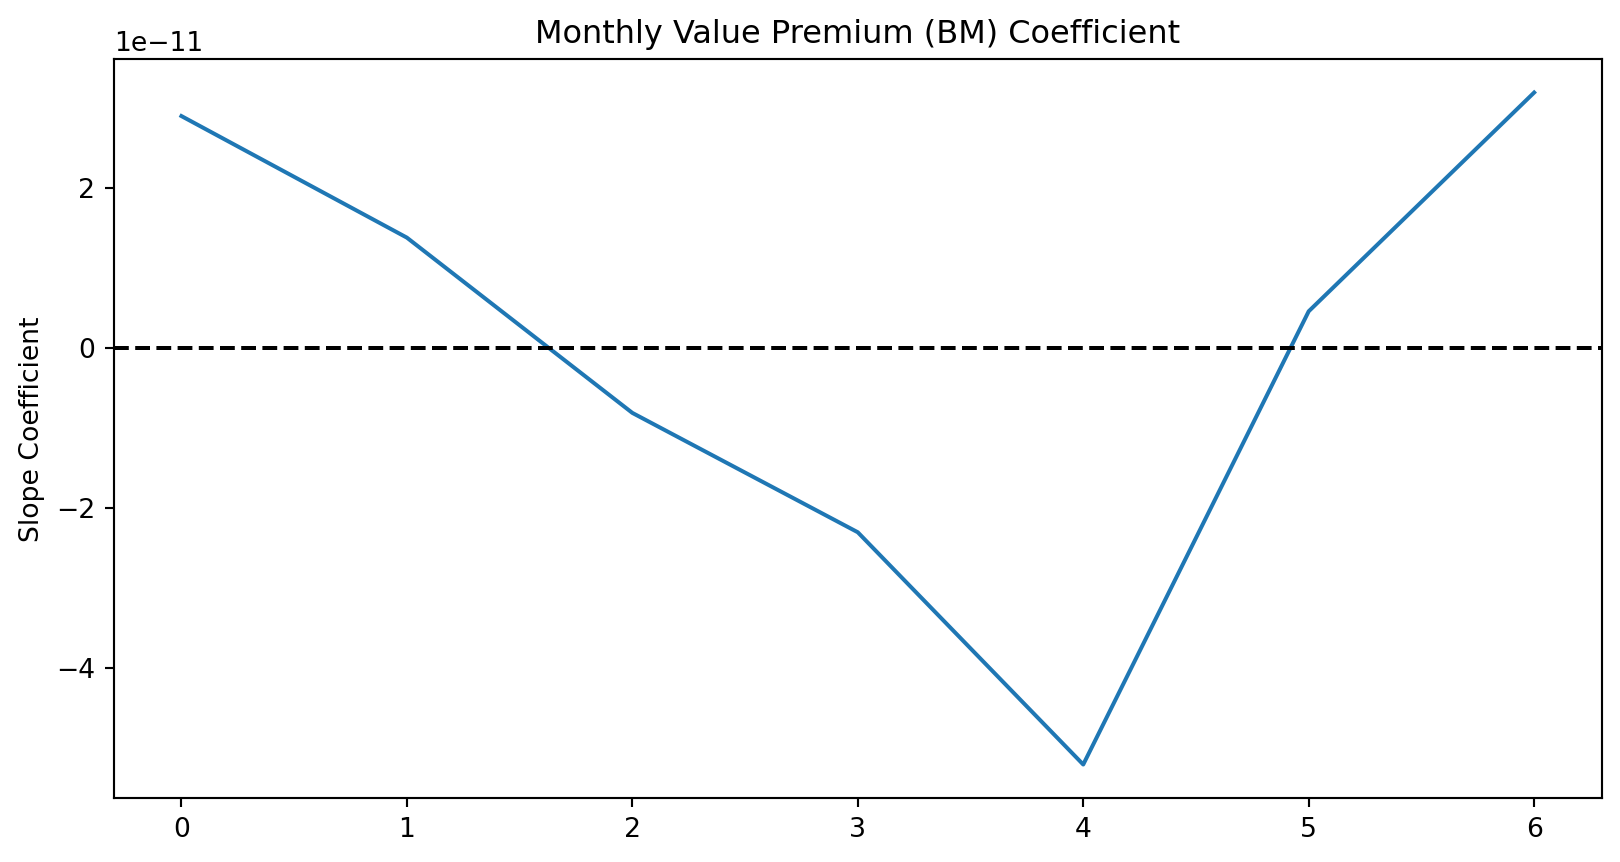
20.5.2 Tương quan giữa các đặc điểm (đa cộng tuyến)
Ở Việt Nam, các cổ phiếu vốn hóa lớn (log_mktcap cao) thường là những cổ phiếu có tỷ số giá trị sổ sách trên giá trị thị trường cao (ngân hàng/công ty tiện ích) hoặc có beta đặc thù. Nếu các nhân tố của bạn có tương quan cao, các hệ số Fama-MacBeth sẽ không ổn định và không có ý nghĩa thống kê (thống kê t thấp), ngay cả khi các nhân tố đó thực sự quan trọng.
Hành động: Kiểm tra tương quan chéo.
# Check correlation of the characteristics
corr_matrix = data_fm[["beta", "log_mktcap", "bm"]].corr()
print(corr_matrix)
beta log_mktcap bm
beta 1.000000 0.392776 -0.033748
log_mktcap 0.392776 1.000000 -0.203307
bm -0.033748 -0.203307 1.000000Diễn giải:
- Nếu tương quan > 0.7 (theo giá trị tuyệt đối), hồi quy khó phân biệt giữa hai nhân tố.
- Chẳng hạn, nếu
SizevàLiquiditycó tương quan -0.8, mô hình không thể biết nhân tố nào đang thúc đẩy lợi nhuận, thường dẫn đến việc cả hai đều có thống kê t không có ý nghĩa.