Hiện mã
import pandas as pd
import numpy as np
import sqlite3
import statsmodels.api as sm

from plotnine import *
from mizani.formatters import percent_format
from regtabletotext import prettify_resultTrong chương này, chúng ta chuyển sang phân loại danh mục đầu tư (portfolio sort), một trong những phương pháp thống kê được sử dụng rộng rãi nhất trong nghiên cứu định giá tài sản thực nghiệm (xem, ví dụ, Bali, Engle, và Murray 2016). Ứng dụng then chốt của phân loại danh mục là kiểm tra xem một hay nhiều biến có thể dự báo lợi nhuận vượt mức trong tương lai hay không. Nhìn chung, ý tưởng là sắp xếp từng cổ phiếu vào các danh mục, trong đó các cổ phiếu trong cùng một danh mục tương tự nhau về một biến phân loại, chẳng hạn quy mô doanh nghiệp. Các danh mục khác nhau khi đó đại diện cho những khoản đầu tư được đa dạng hóa tốt nhưng khác nhau về mức của biến phân loại. Bạn có thể quy các khác biệt trong phân phối lợi nhuận cho tác động của biến phân loại. Chúng ta bắt đầu bằng việc giới thiệu phân loại danh mục đơn biến (chỉ dựa trên một đặc điểm) và xử lý phân loại hai biến trong chương Phân loại theo giá trị và hai biến.
Phân loại danh mục đơn biến chỉ xét một biến phân loại \(x_{i,t-1}\). Ở đây, \(i\) ký hiệu cổ phiếu và \(t-1\) cho biết nhà đầu tư quan sát được đặc điểm này tại thời điểm \(t\). Mục tiêu là đánh giá mối quan hệ theo mặt cắt ngang (cross-sectional) giữa \(x_{i,t-1}\) và, thông thường, lợi nhuận vượt mức của cổ phiếu \(r_{i,t}\) tại thời điểm \(t\) với vai trò biến kết quả. Để minh họa cách phân loại danh mục vận hành, chúng ta dùng các ước lượng beta thị trường từ chương trước làm biến phân loại.
import pandas as pd
import numpy as np
import sqlite3
import statsmodels.api as sm
from plotnine import *
from mizani.formatters import percent_format
from regtabletotext import prettify_resultChúng ta bắt đầu bằng việc tải dữ liệu cần thiết từ cơ sở dữ liệu SQLite đã được giới thiệu trong chương Truy cập và quản lý dữ liệu tài chính và Dữ liệu DataCore. Cụ thể, chúng ta dùng dữ liệu giá cổ phiếu theo tháng làm tập hợp tài sản. Sau khi hình thành các danh mục, chúng ta dùng lợi nhuận nhân tố thị trường để tính hiệu quả điều chỉnh theo rủi ro (tức là alpha). beta là bảng dữ liệu (dataframe) chứa các beta thị trường được tính ở chương trước.
tidy_finance = sqlite3.connect(database="data/tidy_finance_python.sqlite")

prices_monthly = (pd.read_sql_query(
    sql="SELECT symbol, date, ret_excess, mktcap_lag FROM prices_monthly",
    con=tidy_finance,
    parse_dates={"date"})
)

factors_ff3_monthly = pd.read_sql_query(
  sql="SELECT date, mkt_excess FROM factors_ff3_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)

beta = pd.read_sql_query(
  sql="SELECT symbol, date, beta FROM beta_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)Tiếp theo, chúng ta ghép biến phân loại với dữ liệu lợi nhuận. Chúng ta dùng beta trễ một tháng làm biến phân loại để bảo đảm việc phân loại chỉ dựa trên thông tin có sẵn tại thời điểm hình thành danh mục. Để làm trễ beta cổ phiếu một tháng, chúng ta cộng thêm một tháng vào ngày hiện tại và ghép thông tin thu được với dữ liệu lợi nhuận. Quy trình này bảo đảm thông tin của tháng \(t\) có sẵn trong tháng \(t+1\). Bạn có thể bị cám dỗ dùng đơn giản một lệnh như prices_monthly['beta_lag'] = prices_monthly.groupby('symbol')['beta'].shift(1). Tuy nhiên, cách này không hoạt động đúng nếu chuỗi thời gian có các giá trị thiếu ngầm định.
beta_lag = (beta
  .assign(date=lambda x: x["date"]+pd.DateOffset(months=1))
  .get(["symbol", "date", "beta"])
  .rename(columns={"beta": "beta_lag"})
  .dropna()
)

data_for_sorts = (prices_monthly
  .merge(beta_lag, how="inner", on=["symbol", "date"])
  .dropna()
)
Bước đầu tiên để phân loại danh mục là tính các điểm cắt theo từng kỳ, dùng để nhóm cổ phiếu vào các danh mục. Để đơn giản, chúng ta bắt đầu với trung vị của beta thị trường trễ làm điểm cắt duy nhất. Sau đó, chúng ta tính lợi nhuận theo trọng số vốn hóa cho từng danh mục trong hai danh mục thu được, nghĩa là vốn hóa thị trường trễ quyết định trọng số trong np.average().
beta_portfolios = (
    data_for_sorts
    .groupby("date")
    .apply(lambda x: (
        x.assign(
            portfolio=pd.qcut(x["beta_lag"], q=[0, 0.5, 1], labels=["low", "high"]),
            date=x.name
        )
    ))
    .reset_index(drop=True)
    .groupby(["portfolio", "date"])
    .apply(lambda x: np.average(x["ret_excess"], weights=x["mktcap_lag"]))
    .reset_index(name="ret")
    .dropna(subset=['ret'])
)
beta_portfolios.head()| portfolio | date | ret | |
|---|---|---|---|
| 0 | low | 2016-08-31 | -0.016507 |
| 1 | low | 2016-09-30 | -0.089155 |
| 2 | low | 2016-11-30 | -0.015080 |
| 3 | low | 2017-01-31 | 0.004113 |
| 4 | low | 2017-02-28 | 0.035101 |
Chúng ta có thể xây dựng một chiến lược mua–bán khống (long–short) dựa trên hai danh mục: mua danh mục beta cao và đồng thời bán khống danh mục beta thấp. Nhờ vậy, vị thế tổng thể trên thị trường bằng không.
beta_longshort = (beta_portfolios
  .pivot_table(index="date", columns="portfolio", values="ret")
  .reset_index()
  .assign(long_short=lambda x: x["high"]-x["low"])
)
Chúng ta tính lợi nhuận trung bình và sai số chuẩn tương ứng để kiểm định xem danh mục mua–bán khống có đem lại lợi nhuận vượt mức trung bình dương hay âm hay không. Trong tài liệu về định giá tài sản, người ta thường điều chỉnh tự tương quan bằng thống kê \(t\) của Newey và West (1987) để kiểm định giả thuyết không rằng lợi nhuận vượt mức trung bình của danh mục bằng không. Một đầu vào cần thiết cho sai số chuẩn Newey–West là độ rộng băng thông (bandwidth) được chọn dựa trên số độ trễ dùng cho ước lượng. Các nhà nghiên cứu thường mặc định chọn độ dài trễ định trước là sáu tháng (đây không phải là cách tiếp cận dựa trên dữ liệu). Chúng ta thực hiện điều này trong hàm fit() bằng cách chỉ định cov_type là HAC và cung cấp độ dài trễ tối đa thông qua một từ điển tham số bổ sung.
model_fit = (sm.OLS.from_formula(
    formula="long_short ~ 1",
    data=beta_longshort
  )
  .fit(cov_type="HAC", cov_kwds={"maxlags": 6})
)
prettify_result(model_fit)
OLS Model:
long_short ~ 1
Coefficients:
Estimate Std. Error t-Statistic p-Value
Intercept 0.006 0.006 1.018 0.309
Summary statistics:
- Number of observations: 53
- R-squared: 0.000, Adjusted R-squared: 0.000
- F-statistic not available
Kết quả cho thấy chúng ta không thể bác bỏ giả thuyết không rằng lợi nhuận trung bình bằng không. Chiến lược danh mục dùng trung vị làm điểm cắt không đem lại lợi nhuận bất thường nào. Phát hiện này có gây ngạc nhiên không nếu bạn xem xét lại CAPM? Chắc chắn là có. CAPM dự báo rằng cổ phiếu beta cao phải đem lại lợi nhuận kỳ vọng cao hơn. Phân loại danh mục của chúng ta ngầm mô phỏng một chiến lược đầu tư tài trợ việc mua cổ phiếu beta cao bằng cách bán khống cổ phiếu beta thấp. Do đó, ta kỳ vọng lợi nhuận vượt mức trung bình sẽ đem lại mức lợi nhuận cao hơn lãi suất phi rủi ro.
Bây giờ, chúng ta đưa phân loại danh mục lên một tầm cao hơn. Chúng ta muốn có thể phân loại cổ phiếu vào một số lượng danh mục tùy ý. Trong trường hợp này, lập trình hàm rất tiện lợi: chúng ta định nghĩa một hàm cho phép linh hoạt về việc dùng biến nào để phân loại, ký hiệu là sorting_variable. Chúng ta dùng np.quantile() để tính các điểm cắt cho n_portfolios. Sau đó, chúng ta gán danh mục cho cổ phiếu bằng hàm pd.cut(). Đầu ra của hàm dưới đây là một cột mới chứa số hiệu của danh mục mà cổ phiếu thuộc về.
Trong một số ứng dụng, biến dùng để phân loại có thể bị tập trung (ví dụ, tại cận dưới bằng 0). Khi đó, nhiều điểm cắt có thể trùng nhau, dẫn đến các danh mục rỗng. Tương tự, một số danh mục có thể có rất ít cổ phiếu vào đầu mẫu. Những trường hợp số lượng cổ phiếu cấu thành danh mục chênh lệch đáng kể do phân phối của các đặc điểm cần được cân nhắc cẩn thận và, tùy ứng dụng, có thể cần các cách phân loại tùy chỉnh.
def assign_portfolio(data, sorting_variable, n_portfolios):
    """Assign portfolios to a bin between breakpoints."""

    breakpoints = np.quantile(
      data[sorting_variable].dropna(),
      np.linspace(0, 1, n_portfolios + 1),
      method="linear"
    )

    assigned_portfolios = pd.cut(
      data[sorting_variable],
      bins=breakpoints,
      labels=range(1, breakpoints.size),
      include_lowest=True,
      right=False
    )

    return assigned_portfolios
Chúng ta có thể dùng hàm trên để phân loại cổ phiếu vào mười danh mục mỗi tháng dựa trên beta trễ và tính lợi nhuận theo trọng số vốn hóa cho từng danh mục. Lưu ý rằng chúng ta chuyển cột danh mục thành biến định tính (categorical) vì điều này thuận tiện hơn cho việc dựng hình bên dưới.
beta_portfolios = (data_for_sorts
  .groupby("date")
  .apply(lambda x: x.assign(
      portfolio=assign_portfolio(x, "beta_lag", 10)
    ), include_groups=False
  )
  .reset_index(level="date")
  .groupby(["portfolio", "date"])
  .apply(lambda x: pd.Series({
      "ret": np.average(x["ret_excess"], weights=x["mktcap_lag"])
    }), include_groups=False
  )
  .reset_index()
  .merge(factors_ff3_monthly, how="left", on="date")
)Ở bước tiếp theo, chúng ta tính các thống kê tóm tắt cho từng danh mục beta. Cụ thể, chúng ta tính alpha đã điều chỉnh theo CAPM, beta của từng danh mục beta, và lợi nhuận trung bình.
beta_portfolios_summary = (beta_portfolios
  .groupby("portfolio")
  .apply(lambda x: pd.Series({
      "alpha": sm.OLS.from_formula(
          formula="ret ~ 1 + mkt_excess",
          data=x
        ).fit().params["Intercept"],
      "beta": sm.OLS.from_formula(
          formula="ret ~ 1 + mkt_excess",
          data=x
        ).fit().params["mkt_excess"],
      "ret": x["ret"].mean()
    }), include_groups=False
  )
  .reset_index()
)
beta_portfolios_summary| portfolio | alpha | beta | ret | |
|---|---|---|---|---|
| 0 | 1 | 0.007031 | 0.356225 | 0.003892 |
| 1 | 2 | -0.004215 | 0.227882 | -0.005509 |
| 2 | 3 | -0.010169 | 0.390216 | -0.011241 |
| 3 | 4 | -0.014205 | 0.388342 | -0.015732 |
| 4 | 5 | -0.007220 | 0.616833 | -0.009723 |
| 5 | 6 | 0.010648 | 0.976502 | 0.006577 |
| 6 | 7 | -0.010739 | 0.679145 | -0.012645 |
| 7 | 8 | -0.002757 | 0.991774 | -0.006963 |
| 8 | 9 | -0.003448 | 0.904886 | -0.007174 |
| 9 | 10 | 0.010675 | 1.376356 | 0.004944 |
Hình 9.1 minh họa các alpha CAPM của các danh mục được phân loại theo beta.
beta_portfolios_figure = (
  ggplot(
    beta_portfolios_summary,
    aes(x="portfolio", y="alpha", fill="portfolio")
  )
  + geom_bar(stat="identity")
  + labs(
      x="Portfolio", y="CAPM alpha", fill="Portfolio",
      title="CAPM alphas of beta-sorted portfolios"
    )
  + scale_y_continuous(labels=percent_format())
  + theme(legend_position="none")
)
beta_portfolios_figure.show()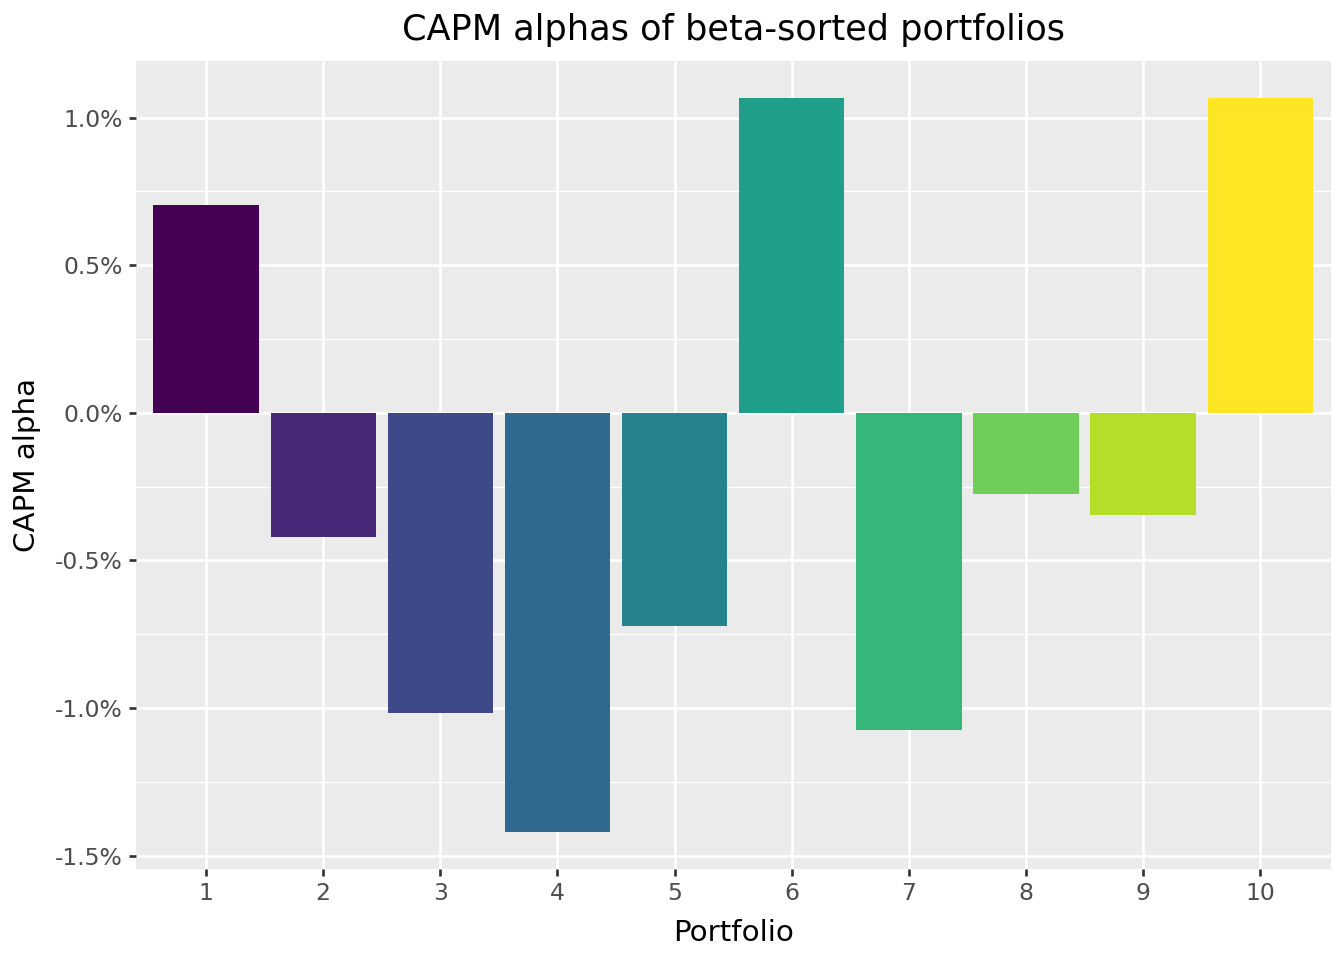
Khác với hiện tượng bất thường “đặt cược chống lại beta” (betting against beta) đã được ghi nhận rõ ràng tại thị trường Mỹ, nơi các danh mục beta thấp có alpha dương và các danh mục beta cao có alpha âm theo một dạng đơn điệu, thị trường Việt Nam không cho thấy mối quan hệ rõ ràng giữa beta và lợi nhuận đã điều chỉnh theo rủi ro. Các alpha dao động mà không có xu hướng rõ rệt giữa các thập phân vị. Việc thiếu quy luật này nhiều khả năng phản ánh giai đoạn mẫu còn ngắn hơn là một kết luận dứt khoát về việc định giá beta tại Việt Nam. Với chuỗi thời gian ngắn như vậy, các hồi quy CAPM ở cấp danh mục chứa nhiễu ước lượng đáng kể, khiến khó phát hiện các hiện tượng bất thường tinh tế. Cần có các giai đoạn mẫu dài hơn để rút ra kết luận đáng tin cậy về việc hiện tượng bất thường beta thấp có tồn tại trên thị trường cổ phiếu Việt Nam hay không.
CAPM dự báo rằng các danh mục của chúng ta phải nằm trên đường thị trường chứng khoán (security market line, SML). Độ dốc của SML bằng phần bù rủi ro thị trường và phản ánh sự đánh đổi giữa rủi ro và lợi nhuận tại bất kỳ thời điểm nào. Hình 9.2 minh họa đường thị trường chứng khoán: Chúng ta thấy rằng (không có gì ngạc nhiên) lợi nhuận của danh mục beta cao có tương quan cao với lợi nhuận thị trường. Tuy nhiên, có vẻ như lợi nhuận vượt mức trung bình của cổ phiếu beta cao thấp hơn mức mà đường thị trường chứng khoán hàm ý là khoản bù đắp “thích đáng” cho rủi ro thị trường cao.
sml_capm = (sm.OLS.from_formula(
    formula="ret ~ 1 + beta",
    data=beta_portfolios_summary
  )
  .fit()
  .params
)

sml_figure = (
  ggplot(
    beta_portfolios_summary,
    aes(x="beta", y="ret", color="factor(portfolio)")
  )
  + geom_point()
  + geom_abline(
      intercept=0, slope=factors_ff3_monthly["mkt_excess"].mean(), linetype="solid"
    )
  + geom_abline(
      intercept=sml_capm["Intercept"], slope=sml_capm["beta"], linetype="dashed"
    )
  + labs(
      x="Beta", y="Excess return", color="Portfolio",
      title="Average portfolio excess returns and beta estimates"
    )
  + scale_x_continuous(limits=(0, 2))
  + scale_y_continuous(labels=percent_format())
)
sml_figure.show()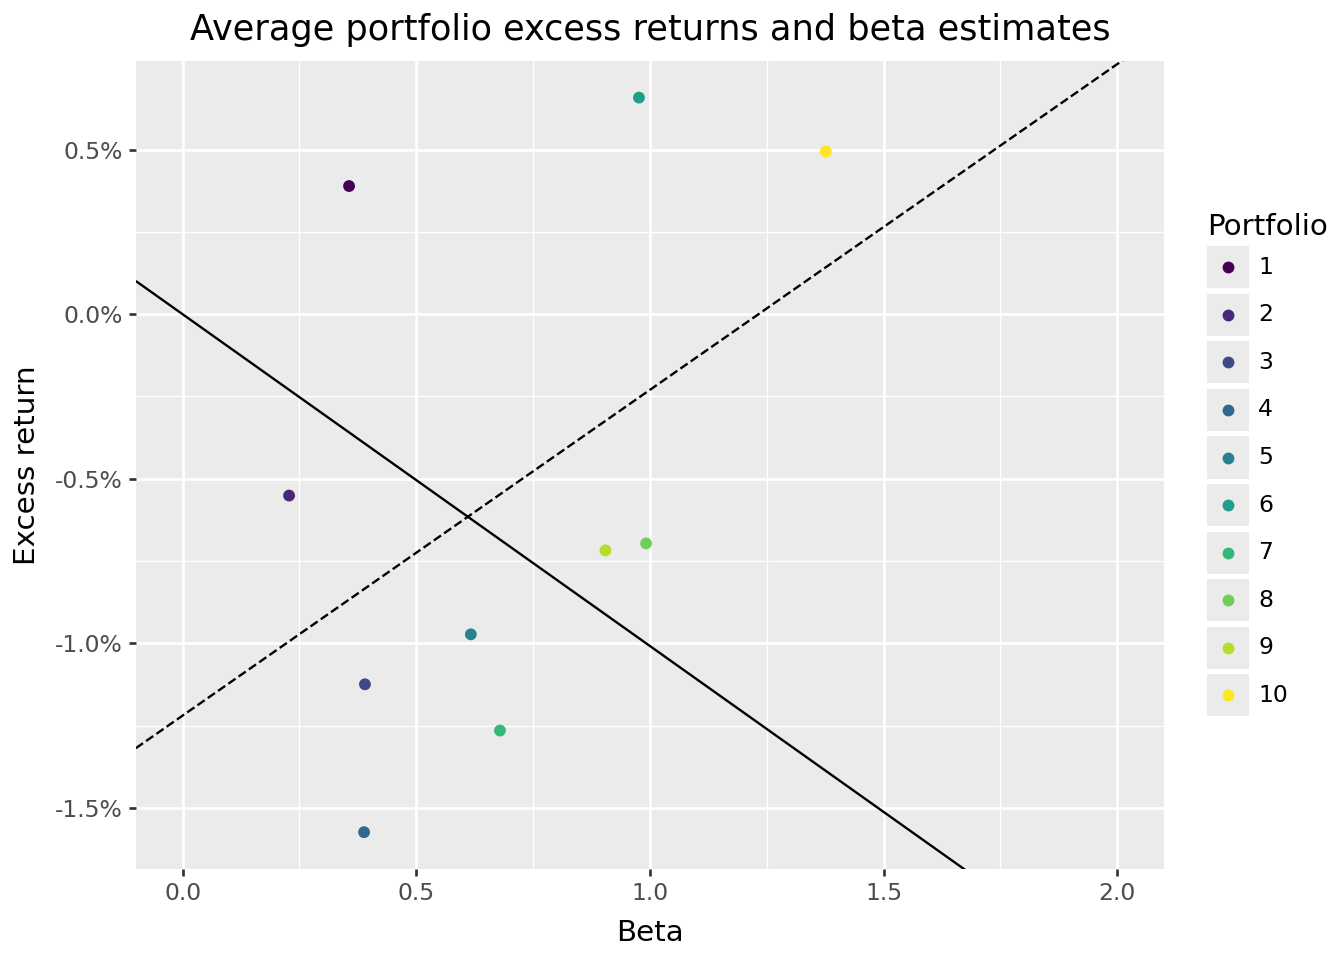
Để cung cấp thêm bằng chứng chống lại các dự báo của CAPM, chúng ta một lần nữa lập chiến lược mua–bán khống: mua danh mục beta cao và bán khống danh mục beta thấp.
beta_longshort = (beta_portfolios
  .assign(
    portfolio=lambda x: (
      x["portfolio"].apply(
        lambda y: "high" if y == x["portfolio"].max()
        else ("low" if y == x["portfolio"].min()
        else y)
      )
    )
  )
  .query("portfolio in ['low', 'high']")
  .pivot_table(index="date", columns="portfolio", values="ret")
  .assign(long_short=lambda x: x["high"]-x["low"])
  .merge(factors_ff3_monthly, how="left", on="date")
)
Một lần nữa, chiến lược mua–bán khống thu được không cho thấy lợi nhuận có ý nghĩa thống kê.
model_fit = (sm.OLS.from_formula(
    formula="long_short ~ 1",
    data=beta_longshort
  )
  .fit(cov_type="HAC", cov_kwds={"maxlags": 1})
)
prettify_result(model_fit)
OLS Model:
long_short ~ 1
Coefficients:
Estimate Std. Error t-Statistic p-Value
Intercept 0.001 0.011 0.095 0.924
Summary statistics:
- Number of observations: 53
- R-squared: 0.000, Adjusted R-squared: 0.000
- F-statistic not available
Tuy nhiên, khi kiểm soát tác động của beta, danh mục mua–bán khống đem lại alpha đã điều chỉnh theo CAPM. Kết quả có thể cung cấp bằng chứng về tính hợp lệ của CAPM tại thị trường Việt Nam. Nhân tố đặt cược chống lại beta đã được ghi nhận rộng rãi tại các thị trường phát triển (Frazzini và Pedersen 2014). Đặt cược chống lại beta tương ứng với chiến lược bán khống cổ phiếu beta cao và nắm giữ vị thế mua (có đòn bẩy) đối với cổ phiếu beta thấp. Nếu các ràng buộc vay mượn ngăn nhà đầu tư thiết lập vị thế trên đường thị trường chứng khoán, thì họ có động cơ mua cổ phiếu beta cao, điều này dẫn đến giá tương đối cao hơn (và do đó lợi nhuận kỳ vọng thấp hơn mức CAPM hàm ý) đối với các cổ phiếu beta cao đó. Kết quả là, chiến lược đặt cược chống lại beta kiếm lời nhờ cung cấp thanh khoản cho các nhà đầu tư bị ràng buộc vốn và có mức e ngại rủi ro thấp hơn.
model_fit = (sm.OLS.from_formula(
    formula="long_short ~ 1 + mkt_excess",
    data=beta_longshort
  )
  .fit(cov_type="HAC", cov_kwds={"maxlags": 1})
)
prettify_result(model_fit)
OLS Model:
long_short ~ 1 + mkt_excess
Coefficients:
Estimate Std. Error t-Statistic p-Value
Intercept 0.004 0.009 0.394 0.694
mkt_excess 1.020 0.116 8.784 0.000
Summary statistics:
- Number of observations: 52
- R-squared: 0.527, Adjusted R-squared: 0.518
- F-statistic: 77.156 on 1 and 50 DF, p-value: 0.000
Hình 9.3 cho thấy lợi nhuận hằng năm của các danh mục beta cực trị mà chúng ta quan tâm chủ yếu. Hình minh họa các quy luật trong giai đoạn mẫu; mỗi danh mục đều có những giai đoạn lợi nhuận hằng năm dương và âm.
beta_longshort_year = (beta_longshort
  .assign(year=lambda x: x["date"].dt.year)
  .groupby("year")
  .aggregate(
    low=("low", lambda x: (1+x).prod()-1),
    high=("high", lambda x: (1+x).prod()-1),
    long_short=("long_short", lambda x: (1+x).prod()-1)
  )
  .reset_index()
  .melt(id_vars="year", var_name="name", value_name="value")
)

beta_longshort_figure = (
  ggplot(
    beta_longshort_year,
    aes(x="year", y="value", fill="name")
  )
  + geom_col(position="dodge")
  + facet_wrap("~name", ncol=1)
  + labs(x="", y="", title="Annual returns of beta portfolios")
  + scale_y_continuous(labels=percent_format())
  + theme(legend_position="none")
)
beta_longshort_figure.show()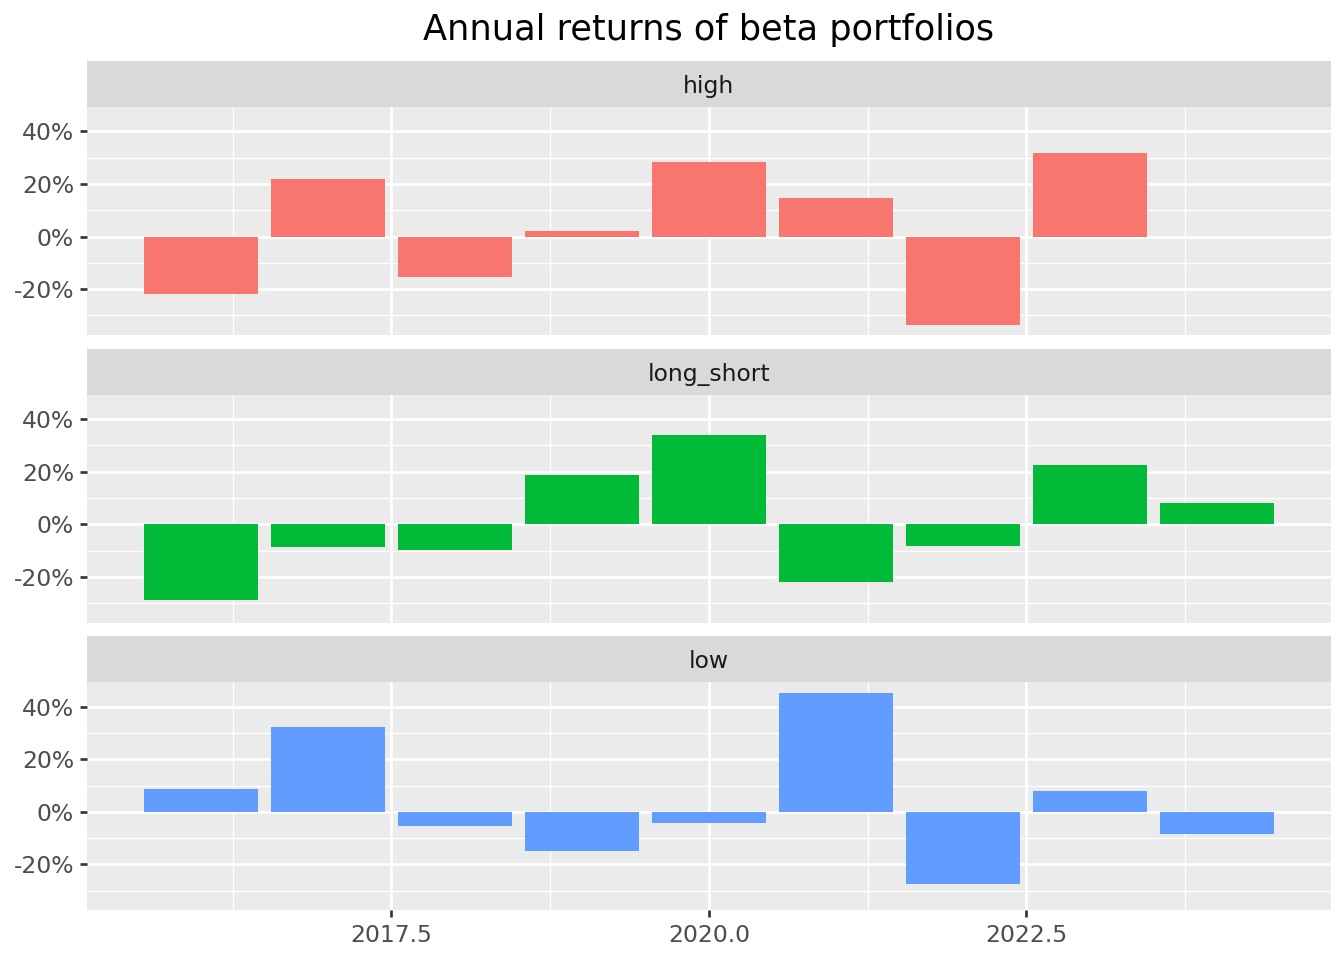
Cả danh mục beta cao và danh mục beta thấp đều biến động đáng kể giữa các năm. Danh mục mua–bán khống, tức mua cổ phiếu beta cao và bán khống cổ phiếu beta thấp, không cho thấy quy luật lợi nhuận dương nhất quán. Hiệu quả thất thường này củng cố phát hiện trước đó của chúng ta rằng mối quan hệ beta–lợi nhuận tại thị trường Việt Nam không phù hợp với các dự báo lý thuyết của CAPM trong giai đoạn mẫu. Mức biến động cao của lợi nhuận hằng năm của danh mục mua–bán khống làm nổi bật rủi ro đáng kể vốn có của chiến lược này, đặc biệt trong bối cảnh thị trường mới nổi với giai đoạn mẫu hạn chế.
Phân loại danh mục đơn biến đánh giá xem một đặc điểm đơn lẻ của doanh nghiệp, như beta thị trường trễ, có thể dự báo lợi nhuận vượt mức trong tương lai hay không.
Các danh mục được hình thành mỗi tháng bằng các điểm cắt theo phân vị, với lợi nhuận được tính bằng trung bình theo trọng số vốn hóa để phản ánh các chiến lược đầu tư thực tế.
Chiến lược mua–bán khống dựa trên các danh mục phân loại theo beta không tạo ra lợi nhuận vượt mức dương có ý nghĩa tại thị trường Việt Nam, trái với dự báo của CAPM rằng beta cao hơn phải đem lại lợi nhuận cao hơn.
Phân tích cung cấp một khung để xem xét hiện tượng bất thường “đặt cược chống lại beta”, trong đó các danh mục beta thấp có thể đem lại alpha cao hơn các danh mục beta cao, qua đó đưa ra bằng chứng về tính hợp lệ của CAPM.
Khả năng lập trình hàm của Python cho phép phân loại danh mục linh hoạt và có thể mở rộng, giúp dễ dàng phân tích nhiều đặc điểm và cấu hình danh mục.
Các thị trường mới nổi như Việt Nam có thể cho thấy mối quan hệ beta–lợi nhuận khác với các thị trường phát triển, nhấn mạnh tầm quan trọng của việc thực hiện phân tích thực nghiệm riêng cho từng thị trường thay vì giả định các hiện tượng bất thường trong định giá tài sản áp dụng phổ quát.