Hiện mã
import pandas as pd
import numpy as np
import sqlite3

from plotnine import *
from mizani.formatters import percent_format
from itertools import product
from joblib import Parallel, delayed, cpu_countTrong chương này, chúng ta tiếp tục với phân loại danh mục trong bối cảnh đơn biến. Tuy nhiên, chúng ta xét quy mô doanh nghiệp làm biến phân loại, từ đó hình thành một nhân tố lợi nhuận nổi tiếng: phần bù quy mô. Phần bù quy mô phát sinh từ việc mua cổ phiếu nhỏ và bán cổ phiếu lớn. Đáng chú ý, Fama và French (1993) đưa nó vào như một nhân tố trong mô hình ba nhân tố của họ. Ngoài ra, các nhà quản lý tài sản thường đưa quy mô vào như một đặc điểm then chốt của doanh nghiệp khi ra quyết định đầu tư.
Chúng ta cũng giới thiệu các lựa chọn mới trong việc hình thành danh mục. Cụ thể, chúng ta thảo luận về sàn niêm yết, ngành, cách đặt trọng số và giai đoạn. Những lựa chọn này ảnh hưởng đến lợi nhuận danh mục và dẫn đến các phần bù quy mô khác nhau (xem Hasler (2021), Soebhag, Van Vliet, và Verwijmeren (2022) và Walter, Weber, và Weiss (2022) để hiểu thêm về các nút quyết định và tác động của chúng lên các phần bù).
import pandas as pd
import numpy as np
import sqlite3
from plotnine import *
from mizani.formatters import percent_format
from itertools import product
from joblib import Parallel, delayed, cpu_countTrước hết, chúng ta lấy dữ liệu liên quan từ cơ sở dữ liệu SQLite đã được giới thiệu trong chương Truy cập và quản lý dữ liệu tài chính và Dữ liệu DataCore. Quy mô doanh nghiệp được định nghĩa là vốn chủ sở hữu theo giá thị trường trong hầu hết các ứng dụng định giá tài sản. Chúng ta còn dùng lợi nhuận nhân tố Fama-French để đánh giá hiệu quả.
tidy_finance = sqlite3.connect(
  database="data/tidy_finance_python.sqlite"
)

prices_monthly = pd.read_sql_query(
  sql="SELECT * FROM prices_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)

factors_ff3_monthly = pd.read_sql_query(
  sql="SELECT * FROM factors_ff3_monthly",
  con=tidy_finance,
  parse_dates={"date"}
)Trước khi xây dựng các danh mục theo quy mô, chúng ta khảo sát phân phối của biến quy mô doanh nghiệp. Trực quan hóa dữ liệu là điểm khởi đầu có giá trị để hiểu đầu vào của phân tích. Hình 10.1 cho thấy tỷ lệ tổng vốn hóa thị trường tập trung ở các doanh nghiệp lớn nhất. Để tạo biểu đồ này, chúng ta lập các chỉ báo theo tháng theo dõi xem một cổ phiếu có thuộc x phần trăm doanh nghiệp lớn nhất hay không. Sau đó, chúng ta gộp các doanh nghiệp trong mỗi nhóm và tính tỷ trọng của từng nhóm trong tổng vốn hóa thị trường.
Hình 10.1 cho thấy 1 phần trăm doanh nghiệp lớn nhất chiếm tới 50 phần trăm tổng vốn hóa thị trường, và chỉ cần nắm giữ 25 phần trăm doanh nghiệp lớn nhất trong tập hợp về cơ bản đã tái tạo được danh mục thị trường. Do đó, phân phối quy mô doanh nghiệp hàm ý rằng các doanh nghiệp lớn nhất của thị trường lấn át nhiều doanh nghiệp nhỏ mỗi khi chúng ta dùng các chuẩn so sánh theo trọng số vốn hóa.
market_cap_concentration = (prices_monthly
  .groupby("date")
  .apply(lambda x: pd.Series({
    "Largest 1%": x.loc[x["mktcap"] >= x["mktcap"].quantile(0.99), "mktcap"].sum() / x["mktcap"].sum(),
    "Largest 5%": x.loc[x["mktcap"] >= x["mktcap"].quantile(0.95), "mktcap"].sum() / x["mktcap"].sum(),
    "Largest 10%": x.loc[x["mktcap"] >= x["mktcap"].quantile(0.90), "mktcap"].sum() / x["mktcap"].sum(),
    "Largest 25%": x.loc[x["mktcap"] >= x["mktcap"].quantile(0.75), "mktcap"].sum() / x["mktcap"].sum()
  }), include_groups=False)
  .reset_index()
  .melt(id_vars="date", var_name="name", value_name="value")
)

market_cap_concentration_figure = (
  ggplot(
    market_cap_concentration,
    aes(x="date", y="value", color="name", linetype="name")
  ) +
  geom_line() +
  scale_y_continuous(labels=percent_format()) +
  scale_x_date(name="", date_labels="%Y") +
  labs(
    x="", y="", color="", linetype="",
    title="Percentage of total market capitalization in largest stocks"
  ) +
  theme(legend_title=element_blank())
)
market_cap_concentration_figure.show()
/tmp/ipykernel_3244990/419327778.py:4: RuntimeWarning: invalid value encountered in scalar divide
/tmp/ipykernel_3244990/419327778.py:5: RuntimeWarning: invalid value encountered in scalar divide
/tmp/ipykernel_3244990/419327778.py:6: RuntimeWarning: invalid value encountered in scalar divide
/tmp/ipykernel_3244990/419327778.py:7: RuntimeWarning: invalid value encountered in scalar divide
/home/mikenguyen/project/tidyfinance/.venv/lib/python3.13/site-packages/plotnine/geoms/geom_path.py:100: PlotnineWarning: geom_path: Removed 17 rows containing missing values.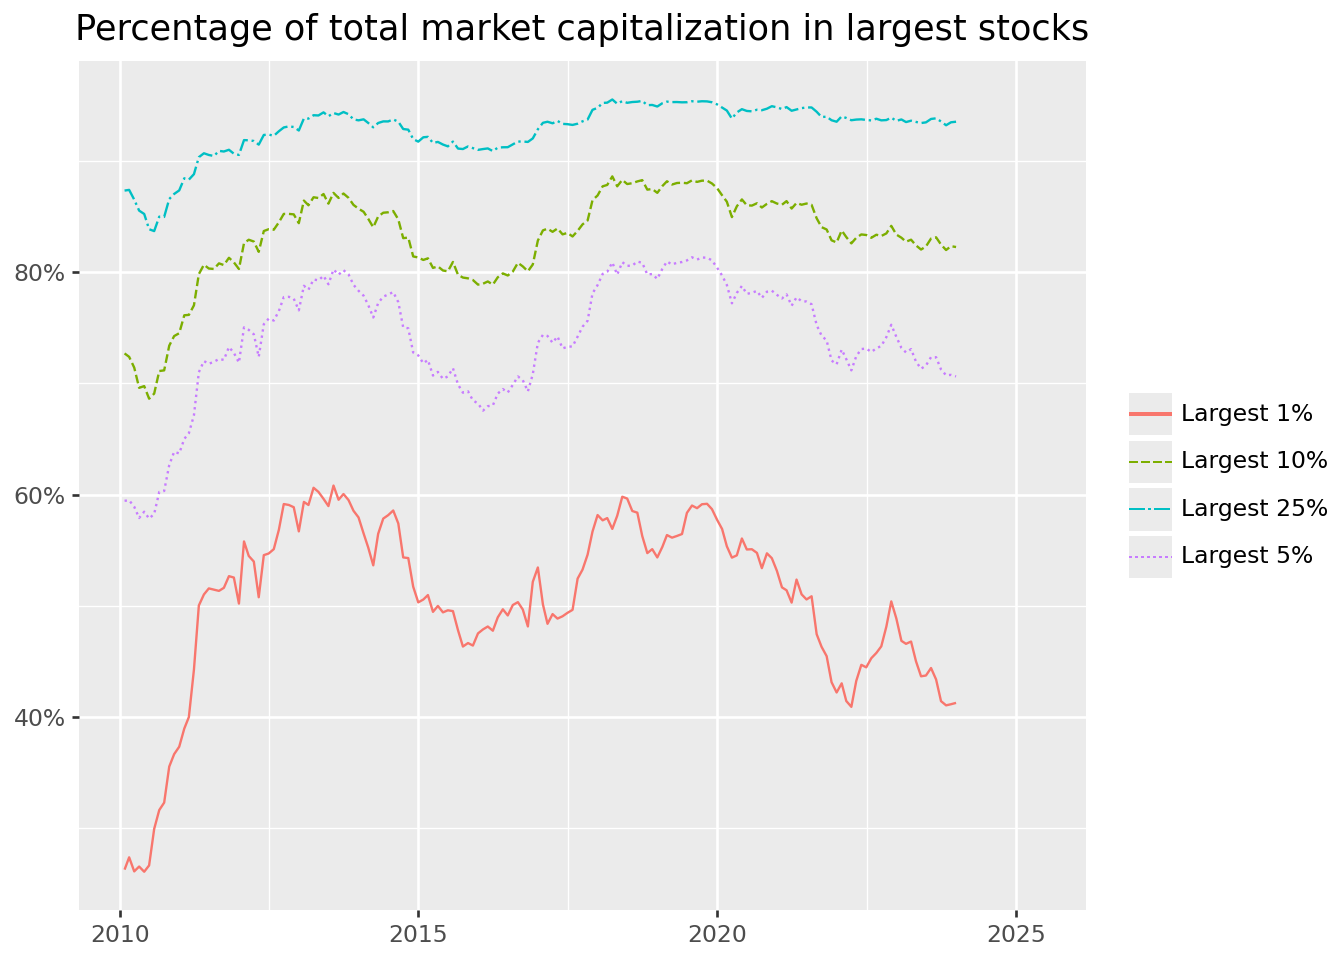
Tiếp theo, quy mô doanh nghiệp cũng khác nhau giữa các sàn niêm yết. Sàn niêm yết chính của cổ phiếu từng quan trọng trong quá khứ và có thể vẫn còn liên quan hiện nay.
market_cap_share = (prices_monthly
  .groupby(["date", "exchange"])
  .aggregate({"mktcap": "sum"})
  .reset_index(drop=False)
  .groupby("date")
  .apply(lambda x:
    x.assign(total_market_cap=lambda x: x["mktcap"].sum(),
             share=lambda x: x["mktcap"]/x["total_market_cap"]
             )
    )
  .reset_index(drop=True)
)

plot_market_cap_share = (
  ggplot(market_cap_share,
         aes(x="date", y="share",
             fill="exchange", color="exchange")) +
  geom_area(position="stack", stat="identity", alpha=0.5) +
  geom_line(position="stack") +
  scale_y_continuous(labels=percent_format()) +
  scale_x_date(name="", date_labels="%Y") +
  labs(x="", y="", fill="", color="",
       title="Share of total market capitalization per listing exchange") +
  theme(legend_title=element_blank())
)
plot_market_cap_share.draw()Cuối cùng, chúng ta xem xét phân phối quy mô doanh nghiệp giữa các sàn niêm yết và lập các thống kê tóm tắt. Hàm describe() không bao gồm mọi thống kê mà chúng ta quan tâm, vì vậy chúng ta tạo hàm compute_summary() bổ sung độ lệch chuẩn và số quan sát. Sau đó, chúng ta áp dụng hàm này cho tháng gần nhất trong dữ liệu trên từng sàn niêm yết. Chúng ta cũng thêm một dòng chứa các thống kê tóm tắt chung. Dưới đây, chúng ta dùng sự phân biệt này để cập nhật quy trình phân loại danh mục.
def compute_summary(data, variable, filter_variable, percentiles):
    """Compute summary statistics for a given variable and percentiles."""

    summary = (data[[filter_variable, variable]]
      .groupby(filter_variable)
      .describe(percentiles=percentiles)
    )

    summary.columns = summary.columns.droplevel(0)

    summary_overall = (data[variable]
      .describe(percentiles=percentiles)
    )

    summary.loc["Overall", :] = summary_overall

    return summary.round(0)

compute_summary(
  prices_monthly[prices_monthly["date"] == prices_monthly["date"].max()],
  variable="mktcap",
  filter_variable="exchange",
  percentiles=[0.05, 0.5, 0.95]
)Trong chương Phân loại danh mục đơn biến, chúng ta xây dựng các danh mục với số lượng điểm cắt thay đổi và các biến phân loại khác nhau. Ở đây, chúng ta mở rộng khung phân tích để tính các điểm cắt trên một tập con của dữ liệu, chẳng hạn dựa trên một số sàn niêm yết được chọn.
Chúng ta đưa exchanges vào làm một đối số trong hàm assign_portfolio() từ chương Phân loại danh mục đơn biến. Đối số theo sàn này sau đó đi vào bộ lọc data["exchanges"].isin(exchanges). Ví dụ, nếu chỉ định exchanges='HOSE', chỉ các cổ phiếu niêm yết trên HOSE được dùng để tính các điểm cắt. Ngoài ra, bạn có thể chỉ định exchanges=["HOSE", "HNX", "UPCoM"], giữ lại tất cả cổ phiếu niêm yết trên một trong các sàn này.
def assign_portfolio(data, exchanges, sorting_variable, n_portfolios):
    """Assign portfolio for a given sorting variable."""

    breakpoints = (data
      .query(f"exchange in {exchanges}")
      .get(sorting_variable)
      .quantile(np.linspace(0, 1, num=n_portfolios+1),
                interpolation="linear")
      .drop_duplicates()
    )
    breakpoints.iloc[[0, -1]] = [-np.Inf, np.Inf]

    assigned_portfolios = pd.cut(
      data[sorting_variable],
      bins=breakpoints,
      labels=range(1, breakpoints.size),
      include_lowest=True,
      right=False
    )

return assigned_portfoliosNgoài việc tính các điểm cắt trên những mẫu khác nhau, các nhà nghiên cứu thường dùng các cách đặt trọng số danh mục khác nhau. Cho đến nay, chúng ta đã đặt trọng số cho mỗi thành phần danh mục theo vốn chủ sở hữu thị trường tương đối của kỳ trước. Quy ước này được gọi là trọng số theo vốn hóa. Quy ước thay thế là trọng số bằng nhau, gán cho lợi nhuận của mỗi cổ phiếu cùng một trọng số, tức là trung bình giản đơn của lợi nhuận các thành phần. Lưu ý rằng trọng số bằng nhau khó thực hiện trong thực tế vì nhà quản lý danh mục cần tái cân bằng danh mục hằng tháng, trong khi trọng số theo vốn hóa là một khoản đầu tư thụ động đúng nghĩa.
Chúng ta triển khai hai cách đặt trọng số trong hàm compute_portfolio_returns(), hàm này nhận một đối số logic để đặt trọng số lợi nhuận theo giá trị doanh nghiệp. Ngoài ra, danh mục mua–bán khống mua các doanh nghiệp nhỏ nhất và bán khống các doanh nghiệp lớn nhất, nhất quán với nghiên cứu cho thấy doanh nghiệp nhỏ vượt trội hơn các doanh nghiệp lớn. Ngoài hai thay đổi này, hàm tương tự quy trình trong chương Phân loại danh mục đơn biến.
def calculate_returns(data, value_weighted):
    """Calculate (value-weighted) returns."""

    if value_weighted:
      return np.average(data["ret_excess"], weights=data["mktcap_lag"])
    else:
      return data["ret_excess"].mean()

def compute_portfolio_returns(n_portfolios=10,
                              exchanges=["HOSE", "HNX", "UPCoM"],
                              value_weighted=True,
                              data=prices_monthly):
    """Compute (value-weighted) portfolio returns."""

    returns = (data
      .groupby("date")
      .apply(lambda x: x.assign(
        portfolio=assign_portfolio(x, exchanges,
                                   "mktcap_lag", n_portfolios))
      )
      .reset_index(drop=True)
      .groupby(["portfolio", "date"])
      .apply(lambda x: x.assign(
        ret=calculate_returns(x, value_weighted))
      )
      .reset_index(drop=True)
      .groupby("date")
      .apply(lambda x:
        pd.Series({"size_premium": x.loc[x["portfolio"].idxmin(), "ret"]-
          x.loc[x["portfolio"].idxmax(), "ret"]}))
      .reset_index(drop=True)
      .aggregate({"size_premium": "mean"})
    )

    return returns
Để thấy hàm compute_portfolio_returns() hoạt động ra sao, chúng ta xét một ví dụ đơn giản với điểm cắt là trung vị và lợi nhuận theo trọng số vốn hóa. Chúng ta quan tâm đến tác động của việc giới hạn sàn niêm yết lên ước lượng phần bù quy mô. Ở lần gọi hàm đầu tiên, chúng ta tính lợi nhuận dựa trên các điểm cắt từ tất cả các sàn niêm yết. Sau đó, chúng ta tính lợi nhuận dựa trên các điểm cắt từ các cổ phiếu niêm yết trên HOSE.
ret_all = compute_portfolio_returns(
  n_portfolios=2,
  exchanges=["HOSE", "HNX", "UPCoM"],
  value_weighted=True,
  data=prices_monthly
)

ret_HOSE = compute_portfolio_returns(
  n_portfolios=2,
  exchanges=["HOSE"],
  value_weighted=True,
  data=prices_monthly
)

data = pd.DataFrame([ret_all*100, ret_HOSE*100],
                    index=["HOSE, HNX & UPCoM", "HOSE"])
data.columns = ["Premium"]
data.round(2)Vì việc chọn sàn niêm yết có tác động đáng kể, bước tiếp theo là khảo sát ảnh hưởng của các quyết định xử lý dữ liệu khác mà nhà nghiên cứu phải đưa ra trong quá trình thực hiện. Cụ thể, mọi phân tích phân loại danh mục đều phải quyết định ít nhất về số lượng danh mục, các sàn niêm yết dùng để hình thành điểm cắt, và trọng số bằng nhau hay trọng số theo vốn hóa. Hơn nữa, người ta có thể loại các doanh nghiệp hoạt động trong ngành tài chính hoặc giới hạn phân tích ở một số phần của chuỗi thời gian. Tất cả các biến thể của những lựa chọn này mà chúng ta thảo luận ở đây đều là một phần của các bài báo học thuật đã công bố trên các tạp chí tài chính hàng đầu. Xem Walter, Weber, và Weiss (2022) để biết thêm một tập hợp rộng các nút quyết định khác thuộc quyền quyết định của nhà nghiên cứu.
Mục đích của ứng dụng này là cho thấy các cách hình thành danh mục khác nhau dẫn đến các phần bù quy mô ước lượng khác nhau. Dù có vô số lựa chọn như vậy, không có một cách duy nhất nào là đúng. Cũng cần lưu ý rằng không có quy trình nào là sai. Mục tiêu đơn giản là minh họa những thay đổi có thể phát sinh do sự biến thiên trong quá trình tạo ra bằng chứng (Menkveld và c.s., không ngày). Thuật ngữ sai số phi chuẩn (non-standard errors) chỉ sự biến thiên do các lựa chọn (hợp lý) của nhà nghiên cứu. Thú vị là, trong một nghiên cứu quy mô lớn, Menkveld và c.s. (không ngày) phát hiện rằng độ lớn của sai số phi chuẩn tương đương với độ bất định ước lượng dựa trên một mô hình đã chọn. Điều này cho thấy việc điều chỉnh cho những lựa chọn tưởng chừng vô hại trong quy trình chuẩn bị và đánh giá dữ liệu quan trọng đến mức nào. Hơn nữa, có vẻ sự bất định liên quan đến phương pháp luận này nên được đón nhận hơn là che giấu.
Từ góc nhìn ác ý, các lựa chọn mô hình hóa này cho nhà nghiên cứu nhiều cơ hội để tìm ra kết quả có ý nghĩa thống kê. Tuy nhiên, điều này bị coi là p-hacking, làm cho suy luận thống kê mất hiệu lực do kiểm định đa giả thuyết (Harvey, Liu, và Zhu 2016).
Tuy vậy, vô số lựa chọn tạo ra một vấn đề vì không có cách phân loại danh mục nào duy nhất đúng. Làm thế nào một nhà nghiên cứu thuyết phục người đọc rằng kết quả của mình không phải do p-hacking? Để tránh thế tiến thoái lưỡng nan này, giới học thuật được khuyến khích trình bày bằng chứng từ các cách phân loại khác nhau dưới dạng kiểm định độ vững và báo cáo nhiều cách tiếp cận để cho thấy kết quả không phụ thuộc vào một lựa chọn duy nhất. Do đó, độ vững của các phần bù là một đặc điểm then chốt.
Dưới đây, chúng ta thực hiện một loạt kiểm định độ vững, cũng có thể được diễn giải như một bài tập p-hacking. Để làm vậy, chúng ta khảo sát phần bù quy mô trong các đặc tả khác nhau được trình bày trong bảng p_hacking_setup. Hàm itertools.product() tạo ra mọi hoán vị có thể của các đối số. Lưu ý rằng chúng ta dùng đối số data để loại các doanh nghiệp tài chính và cắt ngắn chuỗi thời gian.
n_portfolios = [2, 5, 10]
exchanges = [["HOSE"], ["HOSE", "HNX", "UPCoM"]]
value_weighted = [True, False]
data = [
  prices_monthly,
  prices_monthly[prices_monthly["industry"] != "Finance"],
  prices_monthly[prices_monthly["date"] < "1990-06-01"],
  prices_monthly[prices_monthly["date"] >= "1990-06-01"],
]
p_hacking_setup = list(
  product(n_portfolios, exchanges, value_weighted, data)
)
Để tăng tốc tính toán, chúng ta song song hóa (rất nhiều) quy trình phân loại khác nhau. Cuối cùng, chúng ta báo cáo các phần bù quy mô thu được theo thứ tự giảm dần. Quả thật có thể có những phần bù quy mô đáng kể trong dữ liệu của chúng ta, đặc biệt khi dùng các danh mục trọng số bằng nhau.
n_cores = cpu_count()-1
p_hacking_results = pd.concat(
  Parallel(n_jobs=n_cores)
  (delayed(compute_portfolio_returns)(x, y, z, w)
   for x, y, z, w in p_hacking_setup)
)
p_hacking_results = p_hacking_results.reset_index(name="size_premium")Chúng ta cung cấp một biểu đồ trong Hình 10.3 cho thấy các phần bù khác nhau. Hình cũng cho thấy mối quan hệ với phần bù SMB (small minus big) trung bình của Fama-French được dùng trong tài liệu, mà chúng ta đưa vào dưới dạng đường thẳng đứng chấm chấm.
p_hacking_results_figure = (
  ggplot(
    p_hacking_results,
    aes(x="size_premium")
  )
  + geom_histogram(bins=len(p_hacking_results))
  + scale_x_continuous(labels=percent_format())
  + labs(
      x="", y="",
      title="Distribution of size premiums for various sorting choices"
    )
  + geom_vline(
      aes(xintercept=factors_ff3_monthly["smb"].mean()), linetype="dashed"
    )
)
p_hacking_results_figure.show()