Trong chương này, chúng ta trình bày một cách có hệ thống về lợi nhuận kép. Dù xây dựng danh mục mua và nắm giữ, đánh giá hiệu quả của quỹ, tính chỉ số tài sản tích lũy hay ước lượng các thước đo rủi ro dài hạn, khả năng tính đúng lợi nhuận kép trên các kỳ hạn tùy ý đều là điều không thể thiếu. Chúng ta bắt đầu từ nền tảng toán học: sự khác biệt giữa lợi nhuận đơn giản và lợi nhuận logarit, mối quan hệ giữa trung bình cộng và trung bình nhân, cùng các tính chất của lợi nhuận ghép lãi liên tục. Xuyên suốt chương, chúng ta cũng đề cập những vướng mắc thực tế phát sinh trong dữ liệu cổ phiếu, chẳng hạn như tạm ngừng giao dịch, cơ chế biên độ giá, lợi nhuận của kỳ không trọn vẹn và các sự kiện hủy niêm yết, đồng thời chỉ ra cách xử lý chúng trong bối cảnh Việt Nam.
Tiếp theo, chương này trình bày lợi nhuận kép trượt trên các kỳ hạn chuẩn (3, 6, 9 và 12 tháng), lợi nhuận kép được căn theo thời điểm kết thúc kỳ tài chính, lợi nhuận tích lũy hướng về phía trước dùng cho nghiên cứu sự kiện, và ước lượng độ biến động trượt.
Hiện mã
import pandas as pdimport numpy as npimport sqlite3import matplotlib.pyplot as pltfrom plotnine import*from mizani.formatters import percent_format, comma_format, date_formatfrom itertools import productfrom datetime import datetime, timedelta
7.1 Lợi nhuận đơn giản và lợi nhuận logarit
Trước khi bàn về việc tính lãi kép, chúng ta cần phân biệt hai quy ước lợi nhuận cơ bản được dùng trong tài chính.
7.1.1 Lợi nhuận đơn giản (số học)
Lợi nhuận gộp đơn giản của một tài sản từ kỳ \(t-1\) đến \(t\) được định nghĩa là
trong đó \(P_t\) là giá cuối kỳ \(t\) và \(D_t\) là mọi khoản phân phối bằng tiền mặt (cổ tức, lãi trái phiếu) được chi trả trong kỳ \(t\). Lợi nhuận ròng đơn giản chính là \(R_t\). Khi nói về “lợi nhuận” mà không nêu rõ, thông thường chúng ta hiểu đó là lợi nhuận ròng đơn giản.
Tính chất then chốt của lợi nhuận đơn giản là việc ghép lãi nhiều kỳ có dạng nhân:
trong đó \(R_t(k)\) là lợi nhuận kép của \(k\) kỳ kết thúc tại thời điểm \(t\). Cấu trúc nhân này là nền tảng của mọi phương pháp tính lãi kép được trình bày trong chương này.
7.1.2 Lợi nhuận ghép lãi liên tục (logarit)
Lợi nhuận ghép lãi liên tục, hay lợi nhuận logarit, được định nghĩa là
Tính chất cộng này suy ra trực tiếp từ đồng nhất thức logarit \(\ln(ab) = \ln(a) + \ln(b)\). Nó thuận tiện về mặt tính toán vì phép cộng ổn định về số học hơn so với phép nhân lặp, và vì nhiều thủ tục thống kê (trung bình, phương sai, hồi quy) vận hành một cách tự nhiên trên các đại lượng có tính cộng.
Để khôi phục lợi nhuận kép đơn giản từ tổng các lợi nhuận logarit, chúng ta áp dụng hàm mũ:
Với lợi nhuận nhỏ, xấp xỉ \(r_t \approx R_t\) đúng đến bậc một (qua khai triển Taylor \(\ln(1+x) \approx x\) với \(|x| \ll 1\)). Tuy nhiên, với lợi nhuận lớn, điều thường gặp ở các thị trường mới nổi, cổ phiếu vốn hóa nhỏ hoặc giai đoạn khủng hoảng, hai loại lợi nhuận có thể chênh lệch đáng kể. Xét một cổ phiếu tăng giá gấp đôi (\(R_t = 1.0\)): lợi nhuận logarit là \(r_t = \ln(2) \approx 0.693\), lệch 31%. Ngược lại, với cổ phiếu mất một nửa giá trị (\(R_t = -0.5\)): lợi nhuận logarit là \(r_t = \ln(0.5) \approx -0.693\), lớn hơn 39% về độ lớn.
Sự phân kỳ này đặc biệt đáng chú ý ở Việt Nam, nơi biên độ giá hằng ngày \(\pm 7\%\) trên HOSE, \(\pm 10\%\) trên HNX và \(\pm 15\%\) trên UPCoM có thể tạo ra chuỗi các phiên giá trần hoặc giá sàn liên tiếp. Trong một tuần có các phiên giá trần liên tiếp trên HOSE, lợi nhuận đơn giản là \((1.07)^5 - 1 = 40.3\%\) trong khi lợi nhuận logarit là \(5 \times \ln(1.07) = 33.8\%\), một khoảng chênh lệch đáng kể.
Bảng 7.1 minh họa sự phân kỳ này trên một dải các độ lớn lợi nhuận.
Hiện mã
simple_returns = [-0.50, -0.30, -0.15, -0.10, -0.07, -0.05, -0.01,0.00, 0.01, 0.05, 0.07, 0.10, 0.15, 0.30, 0.50, 1.00]comparison_df = pd.DataFrame({"Simple Return": [f"{r:.2%}"for r in simple_returns],"Log Return": [f"{np.log(1+r):.4f}"for r in simple_returns],"Difference": [f"{np.log(1+r) - r:.4f}"for r in simple_returns],"Relative Error (%)": [f"{((np.log(1+r) - r) /abs(r) *100):.2f}"if r !=0else"—"for r in simple_returns ]})comparison_df
Bảng 7.1: So sánh lợi nhuận đơn giản và lợi nhuận logarit với các mức thay đổi giá khác nhau. Độ chênh lệch tăng theo độ lớn của lợi nhuận đơn giản, điều đặc biệt quan trọng đối với các cổ phiếu biến động mạnh của thị trường mới nổi.
Simple Return
Log Return
Difference
Relative Error (%)
0
-50.00%
-0.6931
-0.1931
-38.63
1
-30.00%
-0.3567
-0.0567
-18.89
2
-15.00%
-0.1625
-0.0125
-8.35
3
-10.00%
-0.1054
-0.0054
-5.36
4
-7.00%
-0.0726
-0.0026
-3.67
5
-5.00%
-0.0513
-0.0013
-2.59
6
-1.00%
-0.0101
-0.0001
-0.50
7
0.00%
0.0000
0.0000
—
8
1.00%
0.0100
-0.0000
-0.50
9
5.00%
0.0488
-0.0012
-2.42
10
7.00%
0.0677
-0.0023
-3.34
11
10.00%
0.0953
-0.0047
-4.69
12
15.00%
0.1398
-0.0102
-6.83
13
30.00%
0.2624
-0.0376
-12.55
14
50.00%
0.4055
-0.0945
-18.91
15
100.00%
0.6931
-0.3069
-30.69
Điểm mấu chốt: lợi nhuận logarit thuận tiện cho việc tính lãi kép (cộng gộp), nhưng lợi nhuận danh mục được tổng hợp theo mặt cắt ngang trong không gian lợi nhuận đơn giản. Trong thực tế, chúng ta thường chuyển sang lợi nhuận logarit để ghép lãi theo thời gian, rồi quy đổi trở lại lợi nhuận đơn giản để báo cáo.
đại lượng này biểu diễn mức lợi nhuận không đổi mỗi kỳ sẽ cho cùng giá trị tài sản cuối kỳ như chuỗi lợi nhuận thực tế. Nó luôn nhỏ hơn hoặc bằng trung bình cộng \(\bar{R}_a = \frac{1}{T}\sum_{t=1}^{T} R_t\), và chỉ bằng nhau khi mọi lợi nhuận đều giống nhau. Mối quan hệ xấp xỉ giữa hai đại lượng là:
trong đó \(\sigma^2\) là phương sai của lợi nhuận. Xấp xỉ này, đôi khi được gọi là “lực cản biến động” (volatility drag), có hàm ý quan trọng: các tài sản có độ biến động cao có khoảng cách lớn hơn giữa trung bình cộng và trung bình nhân, nghĩa là mức tăng trưởng kép thực tế thấp hơn so với những gì một giá trị trung bình giản đơn gợi ra. Ở một thị trường như Việt Nam, nơi độ biến động của từng cổ phiếu thường gấp hai đến ba lần so với cổ phiếu ở các thị trường phát triển, lực cản biến động có thể đáng kể.
7.2.2 Chỉ số tài sản và mức sụt giảm
Với khoản đầu tư ban đầu \(W_0\), giá trị tài sản tại thời điểm \(T\) là
Lợi nhuận tích lũy (ròng) đơn giản là \(W_T / W_0 - 1\). Mức sụt giảm tối đa (maximum drawdown), một thước đo rủi ro được dùng rộng rãi, được định nghĩa là
\[
\text{MDD} = \max_{0 \le s \le t \le T} \left(\frac{W_s - W_t}{W_s}\right),
\tag{7.9}\]
đại lượng này đo mức giảm lớn nhất từ đỉnh xuống đáy của chỉ số tài sản. Chúng ta sẽ tính đại lượng này cùng với lợi nhuận kép ở phần sau. Mức sụt giảm đặc biệt hữu ích ở các thị trường mới nổi chịu những đợt điều chỉnh mạnh, như đã xảy ra trong cuộc khủng hoảng tài chính toàn cầu năm 2008 khi VN-Index giảm khoảng 66% so với đỉnh năm 2007.
7.2.3 Quy đổi theo năm
Với lợi nhuận kép \(k\) kỳ \(R_t(k)\) trong đó mỗi kỳ có độ dài \(\Delta\) (ví dụ \(\Delta = 1/12\) với dữ liệu hằng tháng), lợi nhuận quy đổi theo năm là
do đó độ biến động hằng tháng được quy đổi theo năm bằng cách nhân với \(\sqrt{12}\) và độ biến động hằng ngày xấp xỉ nhân với \(\sqrt{252}\) (giả định có 252 ngày giao dịch mỗi năm). Riêng với Việt Nam, HOSE thường có khoảng 245–250 ngày giao dịch mỗi năm sau khi trừ các ngày nghỉ lễ, đủ gần để quy ước \(\sqrt{252}\) vẫn là chuẩn mực.
7.3 Chuẩn bị dữ liệu
Chúng ta bắt đầu bằng việc tải dữ liệu lợi nhuận cổ phiếu hằng tháng từ cơ sở dữ liệu SQLite. Như đã chuẩn bị ở các chương trước, cơ sở dữ liệu này chứa lợi nhuận hằng tháng lấy từ DataCore.vn cho mọi chứng khoán niêm yết trên Sở Giao dịch Chứng khoán TP. Hồ Chí Minh (HOSE), Sở Giao dịch Chứng khoán Hà Nội (HNX) và thị trường giao dịch của các công ty đại chúng chưa niêm yết (UPCoM). Lợi nhuận đã được điều chỉnh theo chia tách cổ phiếu, cổ phiếu thưởng và phát hành quyền mua, đồng thời bao gồm cổ tức tiền mặt tái đầu tư.
print(f"Sample period: {prices_monthly['date'].min()} to "f"{prices_monthly['date'].max()}")print(f"Number of stocks: {prices_monthly['symbol'].nunique():,}")print(f"Total observations: {len(prices_monthly):,}")# print(f"Exchanges: {prices_monthly['exchange'].unique()}")
Sample period: 2010-02-28 00:00:00 to 2023-12-31 00:00:00
Number of stocks: 1,457
Total observations: 165,499
Bảng 7.2 cung cấp thống kê mô tả cho lợi nhuận hằng tháng thô, phân theo sàn giao dịch. Sự khác biệt giữa các sàn phản ánh sự phân tầng về quy mô và thanh khoản: HOSE niêm yết các doanh nghiệp lớn nhất và thanh khoản nhất, HNX bao gồm các công ty vốn hóa trung bình, còn UPCoM là nơi giao dịch các chứng khoán nhỏ hơn và kém thanh khoản hơn.
Bảng 7.2: Thống kê mô tả lợi nhuận cổ phiếu hằng tháng theo sàn giao dịch. Các doanh nghiệp trên HOSE có xu hướng có độ phân tán lợi nhuận thấp hơn và ít quan sát cực đoan hơn so với HNX và UPCoM, phù hợp với vốn hóa thị trường lớn hơn và thanh khoản cao hơn.
Cách trực tiếp nhất để tính lợi nhuận kép là dùng tính chất nhân trong Phương trình 7.2. Với mỗi chứng khoán, chúng ta tính tích lũy kế của các lợi nhuận gộp \((1 + R_t)\) trên cửa sổ mong muốn.
Hiện mã
def compute_cumret_cumprod(df, ret_col="ret_total", group_col="symbol"):"""Compute cumulative returns using cumulative product. Parameters ---------- df : pd.DataFrame Must contain `group_col`, 'date', and `ret_col`. ret_col : str Column name for period returns. group_col : str Column name for grouping (e.g., security identifier). Returns ------- pd.DataFrame Original DataFrame augmented with 'cumret' and 'wealth_index'. """ df = df.sort_values([group_col, "date"]).copy() df["gross_ret"] =1+ df[ret_col] df["wealth_index"] = ( df.groupby(group_col)["gross_ret"] .cumprod() ) df["cumret"] = df["wealth_index"] -1 df.drop(columns=["gross_ret"], inplace=True)return df
Chúng ta hãy áp dụng cách này cho toàn bộ mẫu và xem xét các chỉ số tài sản thu được của một vài cổ phiếu được chọn:
Hiện mã
stock_cumret = compute_cumret_cumprod(prices_monthly)# Select stocks with long histories for illustrationstock_counts = ( stock_cumret.groupby("symbol")["date"] .count() .reset_index(name="n_obs"))long_history_stocks = ( stock_counts.nlargest(5, "n_obs")["symbol"].tolist())sample_wealth = stock_cumret[ stock_cumret["symbol"].isin(long_history_stocks)]
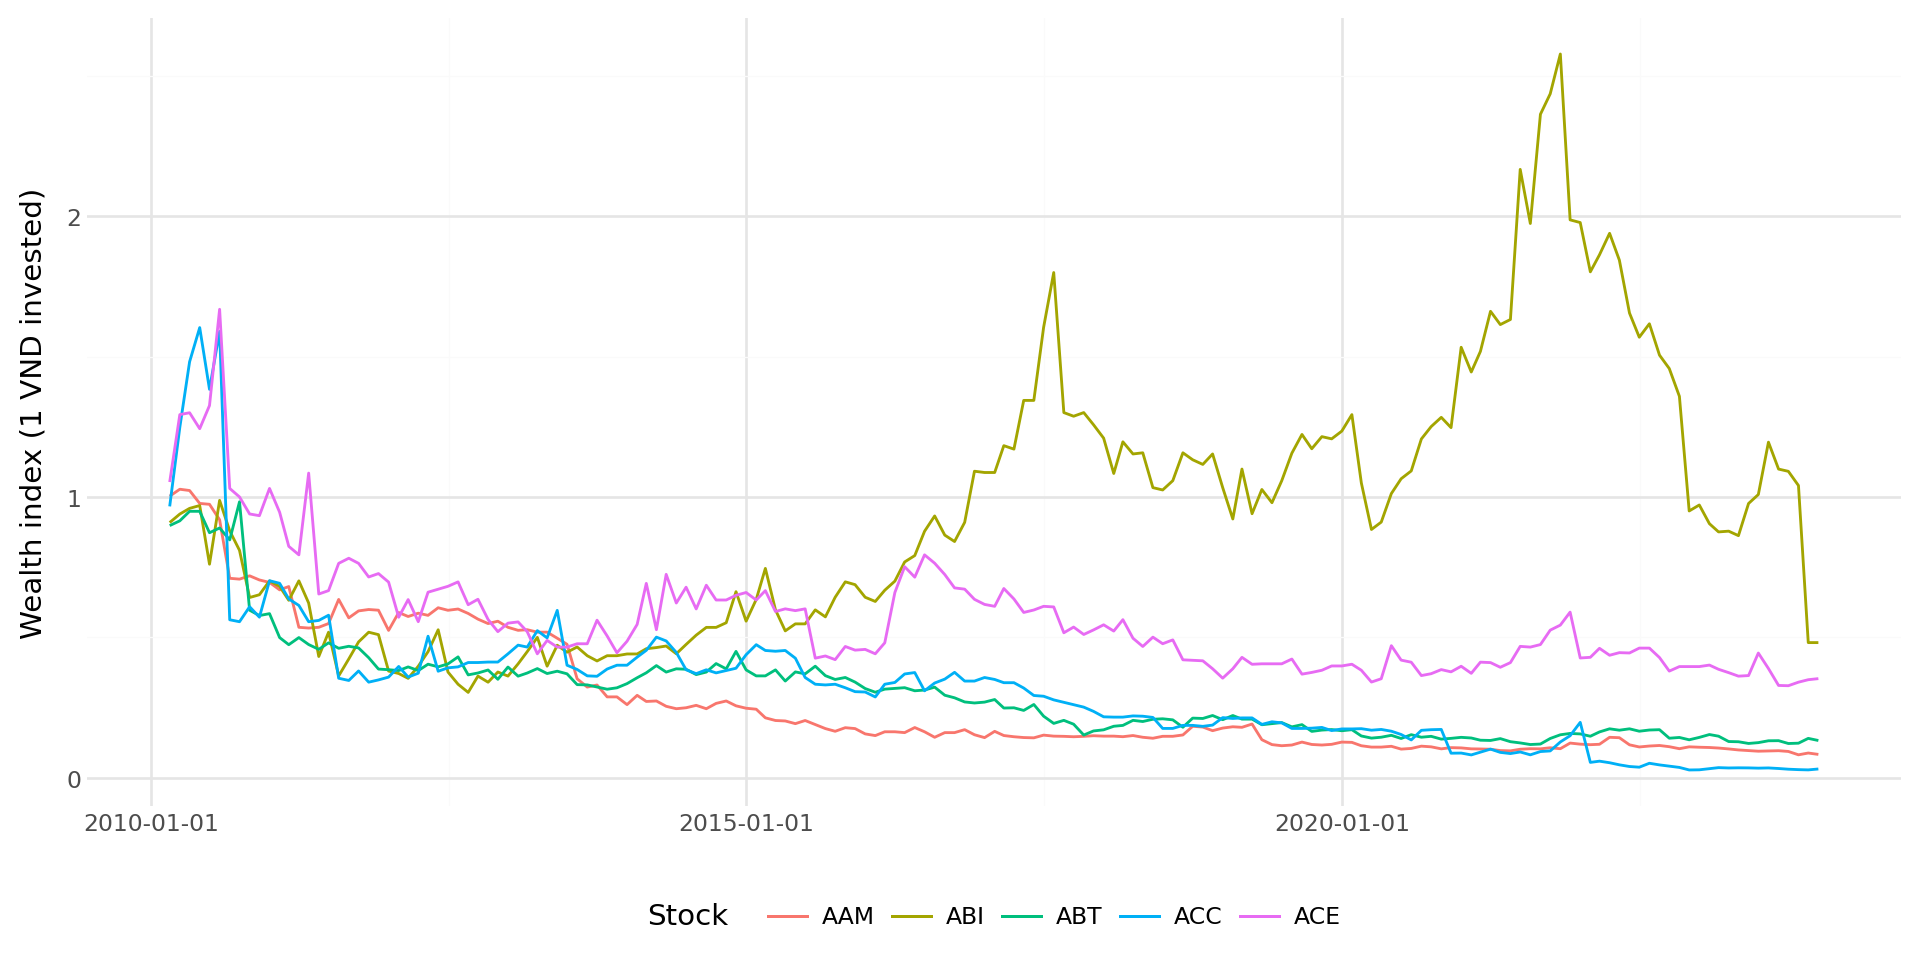
Hình 7.1 vẽ các chỉ số tài sản (giá trị của 1 VND đầu tư) của năm chứng khoán này trong toàn bộ giai đoạn mẫu.
Hình 7.1: Chỉ số tài sản (giá trị của 1 VND đầu tư) của một số cổ phiếu Việt Nam có lịch sử dài được chọn. Mỗi đường biểu diễn giá trị tích lũy của khoản đầu tư 1 VND vào một cổ phiếu, với toàn bộ cổ tức được tái đầu tư. Sự phân kỳ về tài sản cuối kỳ cho thấy sức mạnh của lãi kép trong các kỳ hạn dài.
7.4.1 Xử lý lợi nhuận bị thiếu
Cách tính tích lũy kế lan truyền giá trị thiếu: nếu bất kỳ \(R_t\) nào là NaN, toàn bộ tích lũy kế từ thời điểm đó trở đi sẽ thành NaN. Cách này thận trọng vì về thực chất giả định rằng một lợi nhuận bị thiếu khiến chỉ số tài sản sau đó không xác định được. Trong nhiều ứng dụng, đây là hành vi mong muốn vì lợi nhuận bị thiếu có thể cho thấy lỗi dữ liệu hoặc giai đoạn cổ phiếu không được giao dịch.
Tuy nhiên, trên thị trường Việt Nam, lợi nhuận bị thiếu có thể phát sinh từ các đợt tạm ngừng giao dịch kéo dài. Ủy ban Chứng khoán Nhà nước (UBCKNN) và các sở giao dịch có thể đình chỉ giao dịch một cổ phiếu vì nhiều lý do quản lý, chẳng hạn chậm công bố báo cáo tài chính, thông báo tái cơ cấu doanh nghiệp đang chờ xử lý, hoặc nghi ngờ thao túng thị trường. Các đợt tạm ngừng này có thể kéo dài vài ngày, vài tuần, thậm chí vài tháng. Trong thời gian đó, giá trị của cổ phiếu không thay đổi (mức giá giao dịch cuối cùng vẫn là giá tham chiếu), nên việc coi lợi nhuận bị thiếu bằng không (tức là không có biến động giá) có thể phù hợp hơn việc lan truyền NaN.
Việc coi lợi nhuận bị thiếu bằng không là một giả định có thể phù hợp hoặc không. Nếu lợi nhuận bị thiếu vì cổ phiếu bị tạm ngừng giao dịch thì giá trị bằng không có thể hợp lý. Nếu lợi nhuận bị thiếu do lỗi dữ liệu hoặc vì cổ phiếu thực sự không được giao dịch (ví dụ, đang chờ niêm yết lại sau một sự kiện doanh nghiệp), việc gán giá trị bằng không có thể gây ra thiên lệch. Hãy luôn tìm hiểu nguyên nhân của các giá trị bị thiếu trước khi quyết định cách xử lý.
7.5 Phương pháp 2: Cách tiếp cận log-sum-exp
Phương pháp log-sum-exp khai thác tính chất cộng của lợi nhuận logarit (Phương trình 7.4). Cách tiếp cận này đặc biệt hữu ích khi tính lợi nhuận kép trên các cửa sổ cố định (ví dụ, lợi nhuận hằng năm từ dữ liệu hằng tháng) vì phép cộng vừa hiệu quả về tính toán vừa ổn định về số học.
Hiện mã
def compute_cumret_logsum(df, ret_col="ret_total", group_col="symbol", date_col="date"):"""Compute cumulative returns using the log-sum-exp approach. Steps: 1. Transform to log returns: r_t = ln(1 + R_t) 2. Cumulative sum of log returns within each group 3. Exponentiate to recover simple cumulative return Parameters ---------- df : pd.DataFrame ret_col : str group_col : str date_col : str Returns ------- pd.DataFrame """ df = df.sort_values([group_col, date_col]).copy() df["log_ret"] = np.log(1+ df[ret_col]) df["cum_log_ret"] = ( df.groupby(group_col)["log_ret"].cumsum() ) df["wealth_index_log"] = np.exp(df["cum_log_ret"]) df["cumret_log"] = df["wealth_index_log"] -1 df.drop(columns=["log_ret", "cum_log_ret"], inplace=True)return df
Chúng ta hãy kiểm tra rằng hai phương pháp cho kết quả giống hệt nhau (đến độ chính xác dấu phẩy động):
Maximum absolute difference between methods: 1.78e-14
Chênh lệch ở mức epsilon máy (\(\approx 10^{-15}\)), xác nhận sự tương đương về số học.
7.5.1 Lợi nhuận kép theo từng kỳ cụ thể
Một công việc phổ biến là tính lợi nhuận kép trong các kỳ lịch (tháng, quý, năm). Phương pháp log-sum-exp phù hợp một cách tự nhiên với phép tổng hợp theo nhóm:
Hiện mã
def compound_return_by_period(df, ret_col="ret_total", group_col="symbol", period="year"):"""Compute compound returns within calendar periods. Parameters ---------- df : pd.DataFrame Must contain 'date' and `ret_col`. period : str One of 'year', 'quarter', 'month'. Returns ------- pd.DataFrame with compound returns per group-period. """ df = df.copy() df["log_ret"] = np.log(1+ df[ret_col])if period =="year": df["period"] = df["date"].dt.yearelif period =="quarter": df["period"] = df["date"].dt.to_period("Q")elif period =="month": df["period"] = df["date"].dt.to_period("M") result = ( df.groupby([group_col, "period"]) .agg( cumret=("log_ret",lambda x: np.exp(x.sum()) -1 ), n_obs=("log_ret", "count"), n_miss=(ret_col, lambda x: x.isna().sum()), start_date=("date", "min"), end_date=("date", "max") ) .reset_index() )return result
Bảng 7.3 trình bày lợi nhuận kép hằng năm cho một tập con các chứng khoán.
/tmp/ipykernel_260635/2619242959.py:13: UserWarning: obj.round has no effect with datetime, timedelta, or period dtypes. Use obj.dt.round(...) instead.
Bảng 7.3: Lợi nhuận kép hằng năm của một số chứng khoán Việt Nam được chọn. Số quan sát hằng tháng không bị thiếu (n_obs) và số quan sát bị thiếu (n_miss) được báo cáo để đánh dấu các năm có thể không đầy đủ. Một cặp cổ phiếu-năm có n_obs thấp hơn đáng kể so với 12 cho thấy cổ phiếu chỉ được niêm yết trong một phần của năm hoặc bị tạm ngừng giao dịch kéo dài.
symbol
period
cumret
n_obs
n_miss
start_date
end_date
9
AAM
2019
-0.2810
12
0
2019-01-31
2019-12-31
10
AAM
2020
-0.1622
12
0
2020-01-31
2020-12-31
11
AAM
2021
0.1250
12
0
2021-01-31
2021-12-31
12
AAM
2022
-0.0913
12
0
2022-01-31
2022-12-31
13
AAM
2023
-0.2337
12
0
2023-01-31
2023-12-31
23
ABI
2019
0.1946
12
0
2019-01-31
2019-12-31
24
ABI
2020
0.2418
12
0
2020-01-31
2020-12-31
25
ABI
2021
0.2896
12
0
2021-01-31
2021-12-31
26
ABI
2022
-0.5085
12
0
2022-01-31
2022-12-31
27
ABI
2023
-0.5042
12
0
2023-01-31
2023-12-31
37
ABT
2019
-0.1893
12
0
2019-01-31
2019-12-31
38
ABT
2020
-0.1400
12
0
2020-01-31
2020-12-31
39
ABT
2021
0.0842
12
0
2021-01-31
2021-12-31
40
ABT
2022
-0.0789
12
0
2022-01-31
2022-12-31
41
ABT
2023
-0.0768
12
0
2023-01-31
2023-12-31
51
ACC
2019
-0.1875
12
0
2019-01-31
2019-12-31
52
ACC
2020
-0.4923
12
0
2020-01-31
2020-12-31
53
ACC
2021
1.2339
12
0
2021-01-31
2021-12-31
54
ACC
2022
-0.8538
12
0
2022-01-31
2022-12-31
55
ACC
2023
0.1027
12
0
2023-01-31
2023-12-31
Quan trọng
Khi số quan sát không bị thiếu (n_obs) nhỏ hơn 12 đối với lợi nhuận hằng năm, lợi nhuận kép chỉ phản ánh một phần của năm. Điều này thường xảy ra vào năm đầu và năm cuối của một chứng khoán niêm yết trên HOSE, HNX hoặc UPCoM, hoặc khi một cổ phiếu chuyển sàn (ví dụ, từ UPCoM lên HOSE khi đáp ứng điều kiện niêm yết). Người dùng cần quyết định giữ lại hay loại bỏ các quan sát không trọn năm này tùy theo thiết kế nghiên cứu của mình.
7.6 Phương pháp 3: Tính lãi kép lặp với logic giữ lại
Trong một số ứng dụng, chúng ta cần kiểm soát chi tiết cách các giá trị bị thiếu, sự kiện hủy niêm yết hay các điều kiện đặc biệt khác ảnh hưởng đến quá trình tính lãi kép. Cách tiếp cận lặp xử lý lần lượt từng quan sát, chuyển tiếp lợi nhuận tích lũy và áp dụng logic có điều kiện ở mỗi bước.
Hiện mã
def compute_cumret_iterative(df, ret_col="ret_total", group_col="symbol", handle_missing="carry"):"""Compute cumulative returns iteratively with flexible missing value handling. Parameters ---------- df : pd.DataFrame ret_col : str group_col : str handle_missing : str 'carry' : treat missing as zero return (carry forward) 'propagate' : propagate NaN (conservative) 'reset' : reset wealth index to 1 after missing spell Returns ------- pd.DataFrame """ df = df.sort_values([group_col, "date"]).copy() results = []for name, group in df.groupby(group_col): cumret =1.0 cumrets = []for _, row in group.iterrows(): ret = row[ret_col]if pd.notna(ret): cumret = cumret * (1+ ret)else:if handle_missing =="propagate": cumret = np.nanelif handle_missing =="reset": cumret =1.0# 'carry' does nothing (cumret unchanged) cumrets.append(cumret) group = group.copy() group["wealth_iter"] = cumrets group["cumret_iter"] = group["wealth_iter"] -1 results.append(group)return pd.concat(results, ignore_index=True)
Ghi chú
Phương pháp lặp là chậm nhất trong bốn cách tiếp cận vì không tận dụng được các phép toán vector hóa của NumPy. Với bộ dữ liệu lớn, hãy ưu tiên Phương pháp 1 hoặc 2, trừ khi logic có điều kiện của Phương pháp 3 là thiết yếu. Trên một bộ dữ liệu có 1 triệu quan sát, Phương pháp 1 chạy trong khoảng 0.1 giây so với hơn 10 giây của Phương pháp 3.
7.6.1 So sánh các cách xử lý giá trị bị thiếu
Để minh họa sự khác biệt giữa ba chiến lược xử lý giá trị bị thiếu, hãy xét một cổ phiếu giả định có một lợi nhuận bị thiếu ở giữa lịch sử của nó:
Bảng 7.4: Effect of different missing value treatments on cumulative returns. The ‘carry’ strategy assumes zero return for missing periods (appropriate for trading halts); ‘propagate’ makes all subsequent values undefined (conservative); ‘reset’ restarts the cumulative product after the missing spell.
Date
Return
Carry
Propagate
Reset
0
2024-01
0.05
0.050000
0.0500
0.050000
1
2024-02
0.03
0.081500
0.0815
0.081500
2
2024-03
NaN
0.081500
NaN
0.000000
3
2024-04
0.04
0.124760
NaN
0.040000
4
2024-05
-0.02
0.102265
NaN
0.019200
5
2024-06
0.06
0.168401
NaN
0.080352
7.7 Phương pháp 4: Lợi nhuận kép trượt
Với nhiều ứng dụng thực nghiệm, gồm chiến lược động lượng, đánh giá hiệu quả đầu tư và ước lượng rủi ro, chúng ta cần lợi nhuận kép trên các cửa sổ trượt có độ dài cố định. Mục này triển khai việc tính lãi kép trượt hiệu quả bằng pandas.
7.7.1 Cửa sổ trượt qua lợi nhuận logarit
Cách hiệu quả nhất là kết hợp phương pháp log-sum-exp với tổng trượt:
Hiện mã
def rolling_compound_return(df, ret_col="ret_total", group_col="symbol", windows=[3, 6, 9, 12]):"""Compute rolling compound returns over specified windows. Parameters ---------- df : pd.DataFrame Must be sorted by [group_col, 'date'] with no gaps. ret_col : str group_col : str windows : list of int Rolling window lengths (in periods). Returns ------- pd.DataFrame with new columns ret_{k} for each window k. """ df = df.sort_values([group_col, "date"]).copy() df["log_ret"] = np.log(1+ df[ret_col])for k in windows: rolling_logsum = ( df.groupby(group_col)["log_ret"] .transform(lambda x: x.rolling( window=k, min_periods=k ).sum() ) ) df[f"ret_{k}"] = np.exp(rolling_logsum) -1 df.drop(columns=["log_ret"], inplace=True)return df
Chúng ta áp dụng cách này cho toàn bộ mẫu để tính lợi nhuận kép 3, 6, 9 và 12 tháng gần nhất:
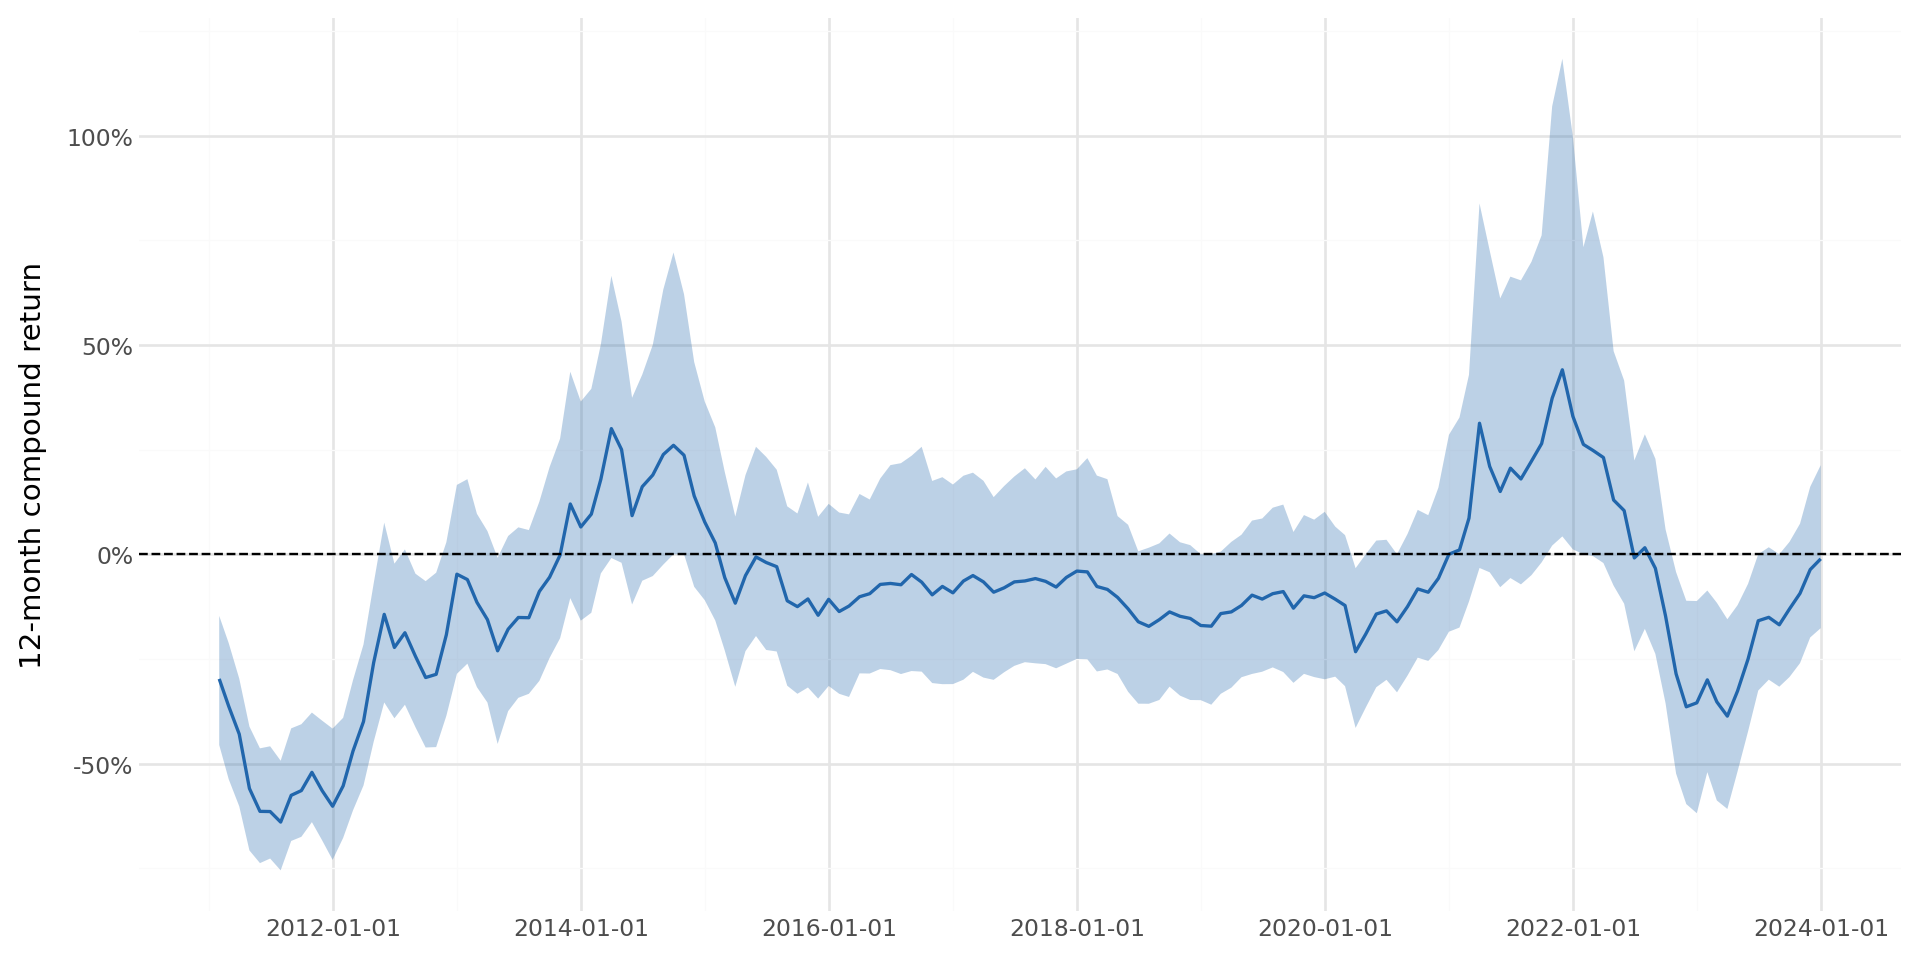
Hình 7.2: Phân phối theo mặt cắt ngang của lợi nhuận kép trượt 12 tháng của các cổ phiếu Việt Nam theo thời gian. Dải tô bóng biểu diễn khoảng tứ phân vị (phân vị thứ 25 đến 75), còn đường liền thể hiện trung vị. Các sự kiện toàn thị trường mạnh, như khủng hoảng tài chính toàn cầu 2008 và cú sốc COVID-19 năm 2020, hiện rõ là những giai đoạn mà ngay cả lợi nhuận trung vị cũng chuyển sang âm mạnh.
7.7.2 Kiểm tra lợi nhuận trượt
Việc kiểm tra lợi nhuận kép trượt bằng phép tính trực tiếp là điều nên làm. Chúng ta chọn một cổ phiếu và tính lại lợi nhuận 12 tháng của nó theo cách thủ công:
/tmp/ipykernel_260635/922053246.py:28: UserWarning: obj.round has no effect with datetime, timedelta, or period dtypes. Use obj.dt.round(...) instead.
Bảng 7.5: Verification of rolling compound return calculation. The ‘Direct’ column computes the product of the preceding 12 monthly gross returns minus one; ‘Rolling’ uses our log-sum-exp function. Differences are at machine precision.
date
ret_12
direct_ret_12
difference
386
2023-09-30
-0.152407
-0.152407
0.0
387
2023-10-31
-0.208836
-0.208836
0.0
388
2023-11-30
-0.199018
-0.199018
0.0
389
2023-12-31
-0.233698
-0.233698
0.0
7.8 Lợi nhuận hủy niêm yết và thiên kiến sống sót
Một vấn đề thực tiễn quan trọng khi tính lợi nhuận kép là cách xử lý các chứng khoán bị loại khỏi sàn giao dịch. Việc hủy niêm yết xảy ra vì nhiều lý do: sáp nhập và mua lại, phá sản, không đáp ứng điều kiện niêm yết, tự nguyện rút niêm yết, hoặc chuyển sang sàn khác. Nếu không đưa lợi nhuận hủy niêm yết vào, lợi nhuận kép thu được chịu thiên kiến sống sót: chúng phóng đại hiệu quả vì các kết quả tệ nhất (phá sản, bị buộc hủy niêm yết) bị loại ra (Shumway 1997).
7.8.1 Bối cảnh Việt Nam
Ở Việt Nam, chứng khoán có thể bị loại khỏi niêm yết trên sàn vì nhiều lý do theo quy định của UBCKNN và các sở giao dịch:
Hủy niêm yết bắt buộc: khi một doanh nghiệp có lỗ lũy kế vượt vốn điều lệ, không đáp ứng nghĩa vụ báo cáo tài chính trong ba năm liên tiếp, hoặc bị thu hồi giấy phép kinh doanh.
Hủy niêm yết tự nguyện: khi cổ đông của doanh nghiệp biểu quyết rút khỏi sàn giao dịch.
Chuyển sàn: khi một doanh nghiệp chuyển từ UPCoM lên HOSE/HNX (nâng cấp) hoặc từ HOSE/HNX xuống UPCoM (hạ cấp). Về mặt kinh tế, những lần chuyển sàn này không phải là hủy niêm yết thực sự nhưng đòi hỏi xử lý cẩn thận khi tính lợi nhuận.
Khác với các thị trường phát triển hơn, nơi dữ liệu chi tiết về lợi nhuận hủy niêm yết được tổng hợp một cách có hệ thống, dữ liệu thị trường Việt Nam có thể không phải lúc nào cũng cung cấp lợi nhuận hủy niêm yết một cách tường minh. Khi một cổ phiếu bị hủy niêm yết do vi phạm hoặc hoàn cảnh bất lợi (ví dụ, phá sản), mức giá giao dịch cuối cùng có thể phóng đại đáng kể giá trị thu hồi của chứng khoán. Các nhà nghiên cứu cần nhận thức hạn chế này và cân nhắc gán lợi nhuận hủy niêm yết dựa trên lý do hủy niêm yết, theo phương pháp của Shumway (1997).
7.8.2 Đưa lợi nhuận hủy niêm yết vào tính toán
Khi một chứng khoán bị hủy niêm yết, một “lợi nhuận hủy niêm yết” cuối cùng phản ánh sự thay đổi giá trị giữa ngày giao dịch thông thường cuối cùng và giá trị thực hiện được sau khi hủy niêm yết. Lợi nhuận này phải được kết hợp với lợi nhuận thông thường trong tháng hủy niêm yết:
trong đó \(R_t\) là lợi nhuận thông thường và \(R_t^{\text{delist}}\) là lợi nhuận hủy niêm yết. Nếu lợi nhuận thông thường bị thiếu (cổ phiếu ngừng giao dịch trước cuối tháng), chúng ta chỉ dùng lợi nhuận hủy niêm yết.
Hiện mã
def adjust_for_delisting(df, ret_col="ret_total", dlret_col="dlret"):"""Adjust returns for delisting events. Parameters ---------- df : pd.DataFrame Must contain `ret_col` and `dlret_col`. Returns ------- pd.DataFrame with adjusted return column 'ret_adj'. """ df = df.copy() df["ret_adj"] = df[ret_col]# Case 1: Both regular and delisting returns available mask_both = df[ret_col].notna() & df[dlret_col].notna() df.loc[mask_both, "ret_adj"] = ( (1+ df.loc[mask_both, ret_col]) * (1+ df.loc[mask_both, dlret_col]) -1 )# Case 2: Only delisting return available mask_dlret_only = ( df[ret_col].isna() & df[dlret_col].notna() ) df.loc[mask_dlret_only, "ret_adj"] = ( df.loc[mask_dlret_only, dlret_col] )return df
7.8.3 Tác động của điều chỉnh hủy niêm yết
Độ lớn của thiên lệch do hủy niêm yết phụ thuộc vào tần suất và mức độ nghiêm trọng của các sự kiện hủy niêm yết. Shumway (1997) cho thấy rằng, ở các thị trường phát triển, việc bỏ qua lợi nhuận hủy niêm yết gây ra thiên lệch hướng lên khoảng 1% mỗi năm trong lợi nhuận danh mục trọng số bằng nhau. Thiên lệch này lớn hơn đối với cổ phiếu vốn hóa nhỏ và cổ phiếu giá trị, vốn dễ gặp khó khăn tài chính hơn. Ở Việt Nam, nơi các doanh nghiệp nhỏ hơn trên HNX và UPCoM chịu ràng buộc thanh khoản chặt hơn và rủi ro vỡ nợ cao hơn, thiên lệch có thể còn rõ rệt hơn. Trong các trường hợp hủy niêm yết ở thị trường mới nổi, hủy niêm yết bắt buộc thường liên quan đến các doanh nghiệp khó khăn tài chính nghiêm trọng, nơi giá trị vốn chủ sở hữu còn lại gần bằng không, hàm ý lợi nhuận hủy niêm yết gần \(-100\%\) trong những trường hợp xấu nhất.
7.9 Ước lượng độ biến động trượt
Độ biến động của lợi nhuận cổ phiếu là đầu vào quan trọng cho quản trị rủi ro, định giá quyền chọn và nhiều mô hình định giá tài sản thực nghiệm. Một cách tiếp cận phổ biến là ước lượng độ lệch chuẩn trượt của lợi nhuận trên một cửa sổ các kỳ gần nhất.
7.9.1 Độ biến động trượt 24 tháng
Theo Ben-David, Franzoni, và Moussawi (2012), chúng ta tính tổng độ biến động lợi nhuận cổ phiếu là độ lệch chuẩn trượt của lợi nhuận hằng tháng trên cửa sổ 24 tháng:
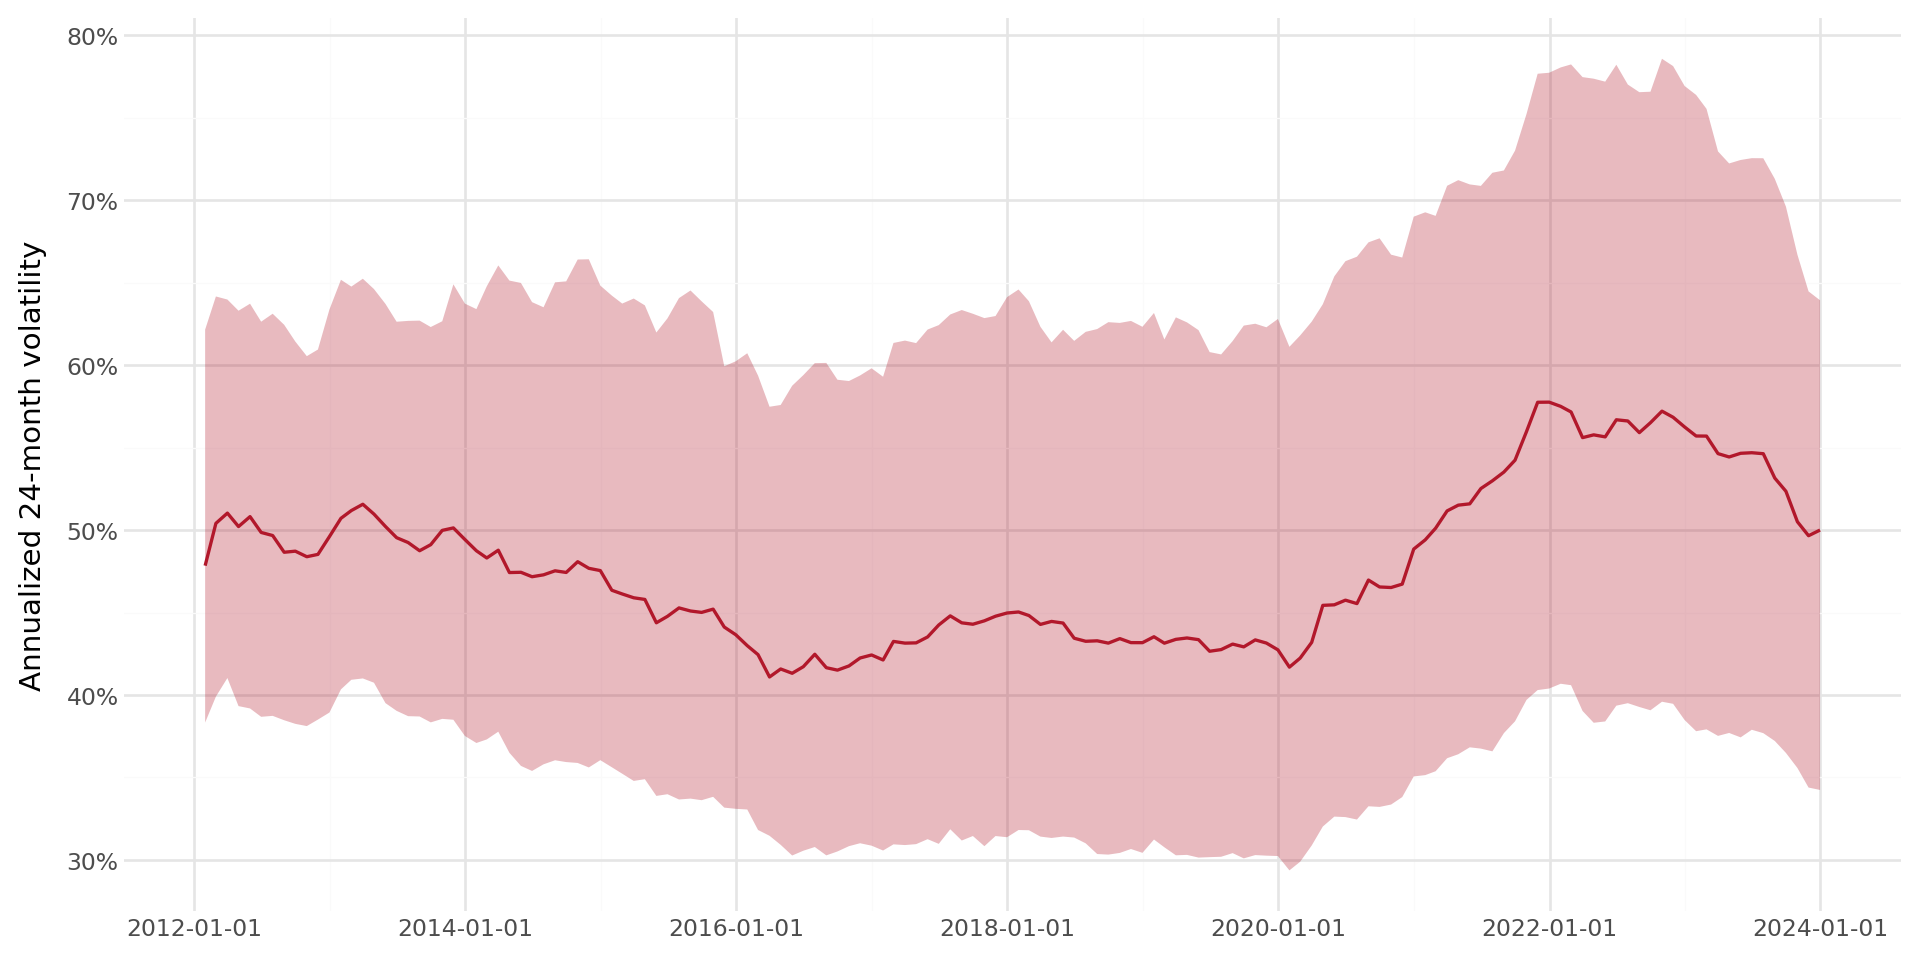
Hình 7.3: Phân phối theo mặt cắt ngang của độ biến động lợi nhuận cổ phiếu trượt 24 tháng, quy đổi theo năm, của các cổ phiếu Việt Nam. Độ biến động trung vị (đường liền) và khoảng tứ phân vị (dải tô bóng) phản ánh cả các xu hướng dài hạn lẫn các giai đoạn khủng hoảng. Cổ phiếu Việt Nam có độ biến động cao hơn hẳn về mặt cấu trúc so với các thị trường phát triển, với độ biến động trung vị quy đổi theo năm thường nằm trong khoảng 30% đến 50%.
7.9.2 Biến động và lợi nhuận kép: Sự hao hụt do phương sai
Như đã nêu trong Phương trình 7.7, lợi nhuận trung bình nhân thấp hơn trung bình cộng khoảng \(\sigma^2/2\). “Sự hao hụt do phương sai” hay “lực cản biến động” này có nghĩa là hai danh mục có cùng lợi nhuận trung bình cộng nhưng độ biến động khác nhau sẽ có lợi nhuận kép khác nhau: danh mục có độ biến động thấp hơn sẽ tăng trưởng kép đến mức tài sản cuối kỳ lớn hơn.
Hiệu ứng này có tầm quan trọng định lượng ở Việt Nam. Một cổ phiếu có lợi nhuận trung bình cộng hằng tháng là 1.5% và độ lệch chuẩn hằng tháng là 10% chịu lực cản biến động khoảng \(0.10^2/2 = 0.5\%\) mỗi tháng, tức xấp xỉ 6% mỗi năm. Điều này phù hợp với quan sát rằng nhà đầu tư Việt Nam chịu sự bào mòn đáng kể đối với mức tăng trưởng kép của tài sản do độ biến động đặc thù cao của từng cổ phiếu. Chúng ta có thể kiểm chứng thực nghiệm điều này bằng cách phân cổ phiếu thành các nhóm ngũ phân vị theo độ biến động và so sánh lợi nhuận kép:
Bảng 7.6: Trung bình cộng, trung bình nhân và độ biến động theo ngũ phân vị độ biến động của các cổ phiếu Việt Nam. Chênh lệch giữa trung bình cộng và trung bình nhân tăng theo độ biến động, xác nhận hiệu ứng hao hụt do phương sai. Lực cản biến động lớn rõ rệt ở nhóm có độ biến động cao nhất, điển hình của các cổ phiếu nhỏ và kém thanh khoản trên HNX và UPCoM.
vol_quintile
arithmetic_mean
geometric_mean
avg_volatility
n_stockyears
0
1
-0.0908
-0.0763
0.1887
2708
1
2
-0.0754
-0.0610
0.3312
2700
2
3
-0.0388
-0.0169
0.4493
2701
3
4
0.0404
0.0494
0.6005
2700
4
5
0.4411
0.3389
1.0288
2705
7.10 Lợi nhuận kép quanh thời điểm kết thúc năm tài chính
Một cách tiếp cận được dùng rộng rãi trong nghiên cứu kế toán và tài chính là căn lợi nhuận kép theo ngày kết thúc kỳ tài chính riêng của từng doanh nghiệp. Điều này thiết yếu để tính lợi nhuận bất thường mua và nắm giữ (BHAR) cho nghiên cứu sự kiện, trôi dạt lợi nhuận sau công bố kết quả kinh doanh (PEAD) và các nghiên cứu khác mà ngày xảy ra sự kiện khác nhau giữa các doanh nghiệp.
Ở Việt Nam, phần lớn doanh nghiệp niêm yết áp dụng năm tài chính theo năm dương lịch (tháng 1 đến tháng 12), theo yêu cầu của Luật Kế toán trừ khi Bộ Tài chính chấp thuận ngoại lệ. Tuy nhiên, các doanh nghiệp trong một số ngành (ví dụ nông nghiệp, du lịch) có thể dùng năm tài chính không chuẩn kết thúc vào tháng 3, tháng 6 hoặc tháng 9.
7.10.1 Căn lợi nhuận theo kỳ tài chính
Thách thức chính là ngày kết thúc năm tài chính khác nhau giữa các doanh nghiệp. Chúng ta cần tính lợi nhuận kép trên các cửa sổ neo vào những ngày riêng của từng doanh nghiệp này.
Hiện mã
def compound_returns_around_event( returns_df, events_df, id_col="symbol", date_col="date", event_date_col="datadate", ret_col="ret_total", pre_windows=[3, 6, 9, 12], post_windows=[3, 6]):"""Compute compound returns in windows around firm-specific event dates. Parameters ---------- returns_df : pd.DataFrame Monthly returns with [id_col, date_col, ret_col]. events_df : pd.DataFrame Event dates with [id_col, event_date_col]. pre_windows : list of int Trailing window lengths (months before event). post_windows : list of int Forward window lengths (months after event). Returns ------- pd.DataFrame with compound returns for each window. """ returns_df = returns_df.sort_values( [id_col, date_col] ).copy() events_df = events_df.copy()# Align event dates to month ends events_df["event_month"] = ( pd.to_datetime(events_df[event_date_col])+ pd.offsets.MonthEnd(0) ) results = []for _, event in events_df.iterrows(): sid = event[id_col] edate = event["event_month"] sec_rets = returns_df[ returns_df[id_col] == sid ].copy() sec_rets = sec_rets.set_index(date_col)[ret_col] row = {id_col: sid, event_date_col: event[event_date_col]}# Pre-event compound returnsfor k in pre_windows: start = edate - pd.DateOffset(months=k-1) start = (start - pd.offsets.MonthEnd(0)+ pd.offsets.MonthEnd(0)) window_rets = sec_rets[ (sec_rets.index >= start)& (sec_rets.index <= edate) ]iflen(window_rets) >= k *0.8: cumret = ( np.exp(np.log(1+ window_rets).sum()) -1 )else: cumret = np.nan row[f"ret_pre_{k}"] = cumret# Post-event compound returnsfor k in post_windows: start = edate + pd.DateOffset(months=1) end = (edate + pd.DateOffset(months=k)+ pd.offsets.MonthEnd(0)) window_rets = sec_rets[ (sec_rets.index >= start)& (sec_rets.index <= end) ]iflen(window_rets) >= k *0.8: cumret = ( np.exp(np.log(1+ window_rets).sum()) -1 )else: cumret = np.nan row[f"ret_post_{k}"] = cumret results.append(row)return pd.DataFrame(results)
7.10.2 Lợi nhuận bất thường mua và nắm giữ so với lợi nhuận bất thường tích lũy
Với nghiên cứu sự kiện và đánh giá hiệu quả đầu tư, chúng ta thường muốn có lợi nhuận kép vượt mức, tức là lợi nhuận kép của cổ phiếu trừ đi lợi nhuận kép của chuẩn so sánh trên cùng cửa sổ. Lợi nhuận bất thường mua và nắm giữ (BHAR) được định nghĩa là
trong đó \(R_{b,t}\) là lợi nhuận của chuẩn so sánh (chỉ số thị trường, danh mục khớp theo quy mô, v.v.). Điều này khác với lợi nhuận bất thường tích lũy (CAR), vốn cộng các lợi nhuận bất thường đơn giản:
BHAR phản ánh tốt hơn trải nghiệm thực tế của nhà đầu tư vì nó thể hiện việc ghép lãi của lợi nhuận, trong khi CAR ngầm giả định tái cân bằng hằng ngày để duy trì các vị thế giá trị bằng nhau trong cổ phiếu và chuẩn so sánh (Barber và Lyon 1997). Sự phân biệt này đặc biệt quan trọng ở Việt Nam, nơi lợi nhuận của từng cổ phiếu có thể biến động mạnh nên hiệu ứng ghép lãi bị khuếch đại. Lyon, Barber, và Tsai (1999) phân tích sâu hơn các tính chất thống kê của BHAR và khuyến nghị dùng giá trị tới hạn bootstrap cho suy luận thống kê.
Nhiều ứng dụng thực nghiệm dùng lợi nhuận kép cũng cần các biến kế toán cấp doanh nghiệp. Một biến thường dùng là giá trị sổ sách của vốn chủ sở hữu, được tính theo Daniel và Titman (1997):
trong đó SE là vốn chủ sở hữu, DT là thuế hoãn lại, ITC là tín dụng thuế đầu tư và PS là giá trị cổ phiếu ưu đãi. Với cổ phiếu ưu đãi, thứ tự ưu tiên là: giá trị mua lại nếu có, sau đó là giá trị thanh lý, rồi đến giá trị ghi sổ.
In Vietnam, the accounting standards (Vietnamese Accounting Standards, VAS, and increasingly IFRS adoption) provide a somewhat different chart of accounts. Stockholders’ equity is reported on the balance sheet as Vốn chủ sở hữu, which includes contributed capital (Vốn góp của chủ sở hữu), share premium (Thặng dư vốn cổ phần), treasury stock adjustments, retained earnings (Lợi nhuận sau thuế chưa phân phối), and other reserves. Deferred tax assets and liabilities are reported separately. Preferred stock is rare among Vietnamese listed firms (most issue only common shares), but when present, its book value should be subtracted from total equity.
Hiện mã
def compute_book_equity(df):"""Compute book value of equity for Vietnamese firms. Parameters ---------- df : pd.DataFrame Must contain at minimum: equity (stockholders' equity), deferred_tax (deferred tax liabilities, net), pref_stock (preferred stock, if applicable). Returns ------- pd.DataFrame with 'be' column. """ df = df.copy() df["pref"] = df.get("pref_stock", pd.Series(0, index=df.index) ) df["dt"] = df.get("deferred_tax", pd.Series(0, index=df.index) ) df["be"] = ( df["equity"].fillna(0)+ df["dt"].fillna(0)- df["pref"].fillna(0) )# Set non-positive book equity to NaN df.loc[df["be"] <=0, "be"] = np.nanreturn df
7.12 Mức sụt giảm tối đa
Mức sụt giảm tối đa là một thước đo rủi ro quan trọng bổ sung cho độ biến động. Trong khi độ biến động đo độ phân tán của lợi nhuận một cách đối xứng, mức sụt giảm tối đa nắm bắt khoản lỗ tích lũy tồi tệ nhất mà nhà đầu tư có thể phải chịu: một thước đo phù hợp hơn với cách nhà đầu tư cảm nhận rủi ro về mặt tâm lý (Kahneman và Tversky 2013).
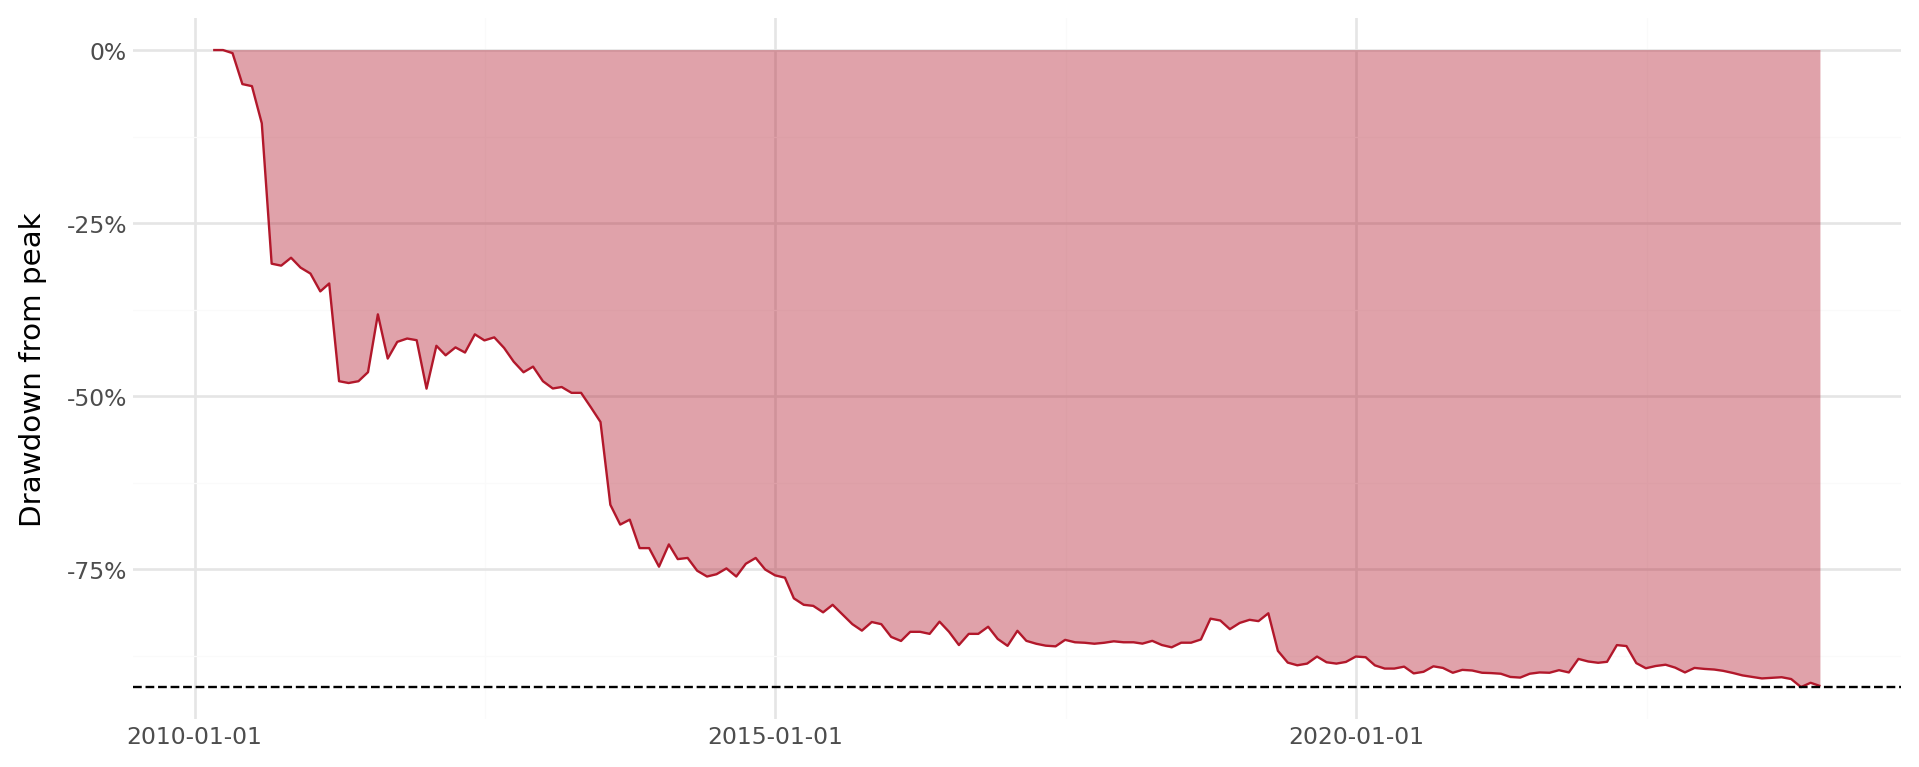
Hình 7.4: Hồ sơ sụt giảm của một cổ phiếu Việt Nam được chọn, thể hiện mức giảm phần trăm so với đỉnh cao nhất tính đến từng thời điểm. Mức sụt giảm tối đa (đường nét đứt nằm ngang) biểu diễn khoản lỗ từ đỉnh xuống đáy tồi tệ nhất trong toàn bộ mẫu. Cổ phiếu Việt Nam thường xuyên có mức sụt giảm vượt 50%, phản ánh độ biến động cao của thị trường và tính dễ bị tổn thương trước các đợt điều chỉnh do tâm lý.
7.13 Tổng hợp lại: Một quy trình xử lý toàn diện
Bây giờ chúng ta kết hợp tất cả các phương pháp thành một quy trình duy nhất tạo ra bộ dữ liệu sẵn sàng cho nghiên cứu, với lợi nhuận kép trượt, lợi nhuận thị trường, độ biến động và các thước đo sụt giảm.
# Build the full datasetcompound_dataset = build_compound_return_dataset(prices_monthly)
Bảng 7.7 cung cấp thống kê mô tả cho các biến chính trong bộ dữ liệu lợi nhuận kép của chúng ta.
Hiện mã
summary_cols = ["ret_total", "ret_3", "ret_6", "ret_12","exret_3", "exret_12", "vol_24", "drawdown"]available_cols = [c for c in summary_colsif c in compound_dataset.columns]summary = ( compound_dataset[available_cols] .describe(percentiles=[0.05, 0.25, 0.50, 0.75, 0.95]) .T .round(4))summary
Bảng 7.7: Thống kê mô tả các biến lợi nhuận kép trên toàn bộ các quan sát cổ phiếu-tháng của Việt Nam. Lợi nhuận ở dạng thập phân (0.10 = 10%). Độ phân tán rộng của lợi nhuận kép 12 tháng và độ biến động trung vị cao phản ánh đặc điểm thị trường mới nổi của thị trường cổ phiếu Việt Nam.
count
mean
std
min
5%
25%
50%
75%
95%
max
ret_total
165499.0
0.0042
0.1862
-0.9900
-0.2381
-0.0703
0.0000
0.0553
0.2773
12.7500
ret_3
162586.0
0.0094
0.3393
-0.9999
-0.3889
-0.1436
-0.0126
0.0987
0.5000
27.2911
ret_6
158227.0
0.0171
0.5053
-0.9999
-0.5095
-0.2196
-0.0400
0.1404
0.7320
35.7136
ret_12
149520.0
0.0375
0.8136
-0.9999
-0.6522
-0.3191
-0.0877
0.1807
1.0767
47.9515
exret_3
153637.0
0.0385
0.3343
-1.1691
-0.3420
-0.1163
0.0067
0.1378
0.4992
27.3041
exret_12
140571.0
0.1401
0.8031
-1.5858
-0.5388
-0.2003
0.0281
0.2880
1.1119
48.0488
vol_24
132233.0
0.5493
0.3488
0.0000
0.2070
0.3445
0.4827
0.6737
1.0739
9.1792
drawdown
165499.0
-0.5927
0.2975
-1.0000
-0.9631
-0.8501
-0.6616
-0.3725
0.0000
0.0000
7.14 Phân phối theo mặt cắt ngang của lợi nhuận kép
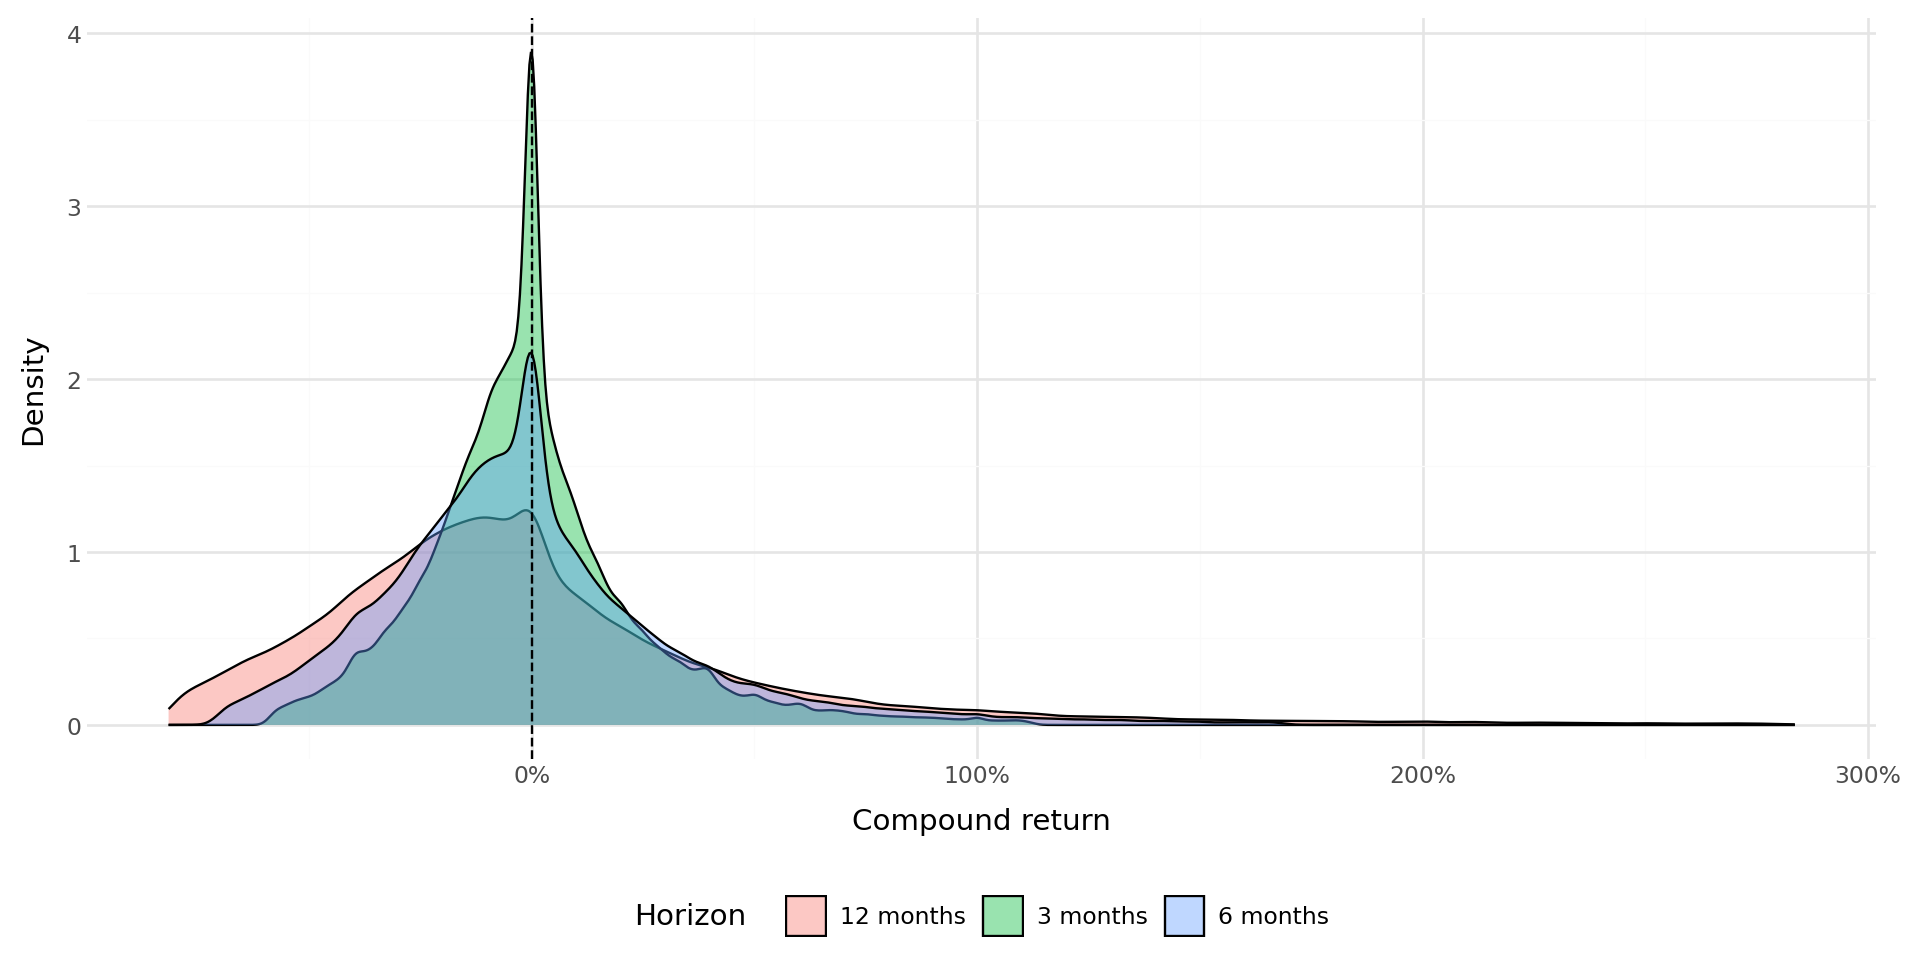
Để hiểu lợi nhuận kép khác nhau thế nào giữa các chứng khoán, chúng ta xem xét phân phối theo mặt cắt ngang ở các kỳ hạn khác nhau.
Hình 7.5: Phân phối theo mặt cắt ngang của lợi nhuận kép ở các kỳ hạn khác nhau (3, 6 và 12 tháng) của các cổ phiếu Việt Nam. Kỳ hạn dài hơn có độ phân tán lớn hơn và độ lệch phải rõ rệt hơn, phản ánh việc ghép lãi của rủi ro đặc thù. Các đuôi dày cực đoan hơn so với thường thấy ở các thị trường phát triển, phù hợp với môi trường biến động cao hơn.
7.15 Những lưu ý riêng của Việt Nam
7.15.1 Biên độ giá và tác động lên việc tính lãi kép
Các sở giao dịch chứng khoán Việt Nam áp đặt biên độ giá hằng ngày, giới hạn mức thay đổi giá tối đa so với giá tham chiếu. Theo các quy định mới nhất:
HOSE: \(\pm 7\%\)
HNX: \(\pm 10\%\)
UPCoM: \(\pm 15\%\)
Các giới hạn này cắt cụt phân phối lợi nhuận hằng ngày và có thể tạo ra chuỗi các phiên chạm biên độ khi có sự kiện thông tin lớn. Với việc tính lợi nhuận kép, điều này có nghĩa là sự điều chỉnh theo thông tin mới có thể trải ra nhiều ngày thay vì diễn ra tức thời. Khi tính lợi nhuận kép hằng tháng từ dữ liệu hằng ngày, điều này được xử lý đúng vì lợi nhuận kép tích lũy toàn bộ mức điều chỉnh bất kể mất bao nhiêu ngày.
Tuy nhiên, biên độ giá có thể gây ra thiên lệch trong việc tính lợi nhuận ở kỳ hạn ngắn. Nếu một sự kiện tích cực lớn xảy ra và cổ phiếu chạm giá trần trong nhiều ngày liên tiếp, lợi nhuận kép 1 ngày hoặc 1 tuần sẽ đánh giá thấp nội dung thông tin thực sự của sự kiện (Kim, Liu, và Yang 2013). Với các ứng dụng nghiên cứu sự kiện, nhà nghiên cứu cần kiểm tra rằng cửa sổ sự kiện đủ dài để bao hàm độ trễ điều chỉnh giá do biên độ giá gây ra.
7.15.2 Giới hạn sở hữu nước ngoài
Việt Nam áp đặt giới hạn sở hữu nước ngoài (FOL) đối với các công ty niêm yết, thường tối đa 49% với hầu hết các ngành và thấp hơn (30% hoặc ít hơn) với một số lĩnh vực hạn chế như ngân hàng và viễn thông. Khi một cổ phiếu đã đạt FOL, nhà đầu tư nước ngoài chỉ có thể mua cổ phiếu từ những người bán là nhà đầu tư nước ngoài khác, tạo ra một thị trường song song có phần bù giá đối với cổ phiếu của khối ngoại. Điều này không trực tiếp ảnh hưởng đến việc tính lợi nhuận kép (vốn dùng giá giao dịch chính thức), nhưng các nhà nghiên cứu về lợi nhuận danh mục xuyên biên giới nên lưu ý rằng mức giá thực tế nhà đầu tư nước ngoài phải trả có thể khác với giá trên bảng giá (Vo 2017).
7.15.3 VN-Index và các chuẩn so sánh thị trường
Đối với lợi nhuận kép của chuẩn so sánh, các chỉ số chính của Việt Nam là:
VN-Index: Chỉ số trọng số theo vốn hóa của tất cả cổ phiếu niêm yết trên HOSE.
VN30: 30 cổ phiếu lớn nhất và thanh khoản nhất trên HOSE, được xem xét định kỳ sáu tháng một lần.
HNX-Index: Chỉ số trọng số theo vốn hóa của các cổ phiếu niêm yết trên HNX.
VN-Index là chuẩn so sánh được dùng rộng rãi nhất và là lợi nhuận thị trường mặc định trong bộ dữ liệu của chúng ta.
7.16 Các cân nhắc về hiệu năng
Khi làm việc với bộ dữ liệu lớn, hiệu quả tính toán rất quan trọng. Bảng 7.8 so sánh thời gian thực thi của bốn phương pháp tính lãi kép trên một bộ dữ liệu chuẩn hóa.
Bảng 7.8: So sánh thời gian thực thi của các phương pháp tính lãi kép khác nhau trên bộ dữ liệu 10,000 quan sát cổ phiếu-tháng. Các phương pháp tích lũy kế và log-sum-exp nhanh hơn nhiều bậc so với cách tiếp cận lặp nhờ vector hóa của NumPy.
Method
Time (seconds)
Relative Speed
0
Cumulative Product
0.0068
1.1x
1
Log-Sum-Exp
0.0064
1.0x
2
Iterative (carry)
0.4896
76.2x
3
Rolling (12-month)
0.0267
4.1x
7.17 Các lỗi thường gặp và thông lệ tốt nhất
Một số vấn đề tinh tế có thể dẫn đến tính sai lợi nhuận kép. Chúng ta tóm tắt những vấn đề quan trọng nhất:
Khoảng trống trong chuỗi thời gian. Nếu một chứng khoán có những tháng không có quan sát (thậm chí không có cả cờ đánh dấu lợi nhuận bị thiếu), các phép tính cửa sổ trượt dựa trên chỉ mục theo vị trí sẽ cho kết quả sai. Cửa sổ trượt sẽ bao phủ sai kỳ lịch. Hãy luôn bảo đảm chuỗi thời gian đầy đủ, điền các khoảng trống bằng giá trị thiếu tường minh trước khi tính các thống kê trượt. Điều này đặc biệt đáng lưu ý ở Việt Nam, nơi các đợt đình chỉ giao dịch có thể tạo ra khoảng trống.
Thiên kiến sống sót. Như đã thảo luận trong mục về lợi nhuận hủy niêm yết, việc loại bỏ các chứng khoán ngừng giao dịch làm lợi nhuận kép bị thiên lệch hướng lên. Hãy luôn đưa lợi nhuận hủy niêm yết vào khi có sẵn. Khi không có lợi nhuận hủy niêm yết (như đôi khi xảy ra với dữ liệu Việt Nam), hãy cân nhắc dùng các giá trị gán dựa trên lý do hủy niêm yết.
Thiên lệch nhìn trước. Khi căn lợi nhuận kép theo ngày kết thúc năm tài chính cho phân tích theo mặt cắt ngang, cần cẩn thận không dùng lợi nhuận trước ngày kết thúc năm tài chính để dự báo lợi nhuận sau công bố. Các doanh nghiệp Việt Nam phải công bố báo cáo tài chính năm đã kiểm toán trong vòng 90 ngày kể từ ngày kết thúc năm tài chính, do đó nên có khoảng đệm ít nhất 3 tháng khi xây dựng lợi nhuận kép hướng về phía trước.
Tràn số trên và tràn số dưới. Với các kỳ hạn ghép lãi rất dài hoặc lợi nhuận cực đoan, tích lũy kế có thể bị tràn số trên (inf) hoặc tràn số dưới (0). Phương pháp log-sum-exp vững hơn trước các vấn đề số học như vậy vì nó vận hành trong không gian logarit, nơi miền giá trị được nén lại.
Quy đổi theo năm của các kỳ không trọn vẹn. Khi tính lợi nhuận quy đổi theo năm từ dữ liệu của kỳ không trọn vẹn (ví dụ, 7 tháng dữ liệu quy đổi lên 12 tháng), công thức quy đổi \((1+R)^{12/k} - 1\) giả định rằng tốc độ lợi nhuận quan sát được sẽ tiếp tục duy trì. Giả định này càng mạnh với các kỳ không trọn vẹn ngắn và có thể cho kết quả gây hiểu lầm. Hãy báo cáo lợi nhuận kép thực tế và số kỳ cùng với mọi con số quy đổi theo năm.
Chuyển sàn. Ở Việt Nam, cổ phiếu đôi khi chuyển giữa UPCoM, HNX và HOSE. Những lần chuyển sàn này có thể kèm theo tạm ngừng giao dịch và có thể gây ra các khoảng trống biểu kiến trong chuỗi lợi nhuận. Khi tính lợi nhuận kép trải qua một lần chuyển sàn, hãy bảo đảm chuỗi lợi nhuận liên tục qua ngày chuyển sàn.
Barber, Brad M, và John D Lyon. 1997. “Detecting long-run abnormal stock returns: The empirical power and specification of test statistics”. Journal of financial economics 43 (3): 341–72.
Ben-David, Itzhak, Francesco Franzoni, và Rabih Moussawi. 2012. “Hedge fund stock trading in the financial crisis of 2007–2009”. The Review of Financial Studies 25 (1): 1–54. https://doi.org/10.1093/rfs/hhr114.
Daniel, Kent, và Sheridan Titman. 1997. “Evidence on the characteristics of cross sectional variation in stock returns”. the Journal of Finance 52 (1): 1–33.
Kahneman, Daniel, và Amos Tversky. 2013. “Prospect theory: An analysis of decision under risk”. Trong Handbook of the fundamentals of financial decision making: Part I, 99–127. World Scientific.
Kim, Kenneth A, Haixiao Liu, và J Jimmy Yang. 2013. “Reconsidering price limit effectiveness”. Journal of Financial Research 36 (4): 493–518.
Lyon, John D, Brad M Barber, và Chih-Ling Tsai. 1999. “Improved methods for tests of long-run abnormal stock returns”. The Journal of Finance 54 (1): 165–201.
Vo, Xuan Vinh. 2017. “Do foreign investors improve stock price informativeness in emerging equity markets? Evidence from Vietnam”. Research in International Business and Finance 42: 986–91.
Mã nguồn
# Lợi nhuận képTrong chương này, chúng ta trình bày một cách có hệ thống về lợi nhuận kép. Dù xây dựng danh mục mua và nắm giữ, đánh giá hiệu quả của quỹ, tính chỉ số tài sản tích lũy hay ước lượng các thước đo rủi ro dài hạn, khả năng tính đúng lợi nhuận kép trên các kỳ hạn tùy ý đều là điều không thể thiếu. Chúng ta bắt đầu từ nền tảng toán học: sự khác biệt giữa lợi nhuận đơn giản và lợi nhuận logarit, mối quan hệ giữa trung bình cộng và trung bình nhân, cùng các tính chất của lợi nhuận ghép lãi liên tục. Xuyên suốt chương, chúng ta cũng đề cập những vướng mắc thực tế phát sinh trong dữ liệu cổ phiếu, chẳng hạn như tạm ngừng giao dịch, cơ chế biên độ giá, lợi nhuận của kỳ không trọn vẹn và các sự kiện hủy niêm yết, đồng thời chỉ ra cách xử lý chúng trong bối cảnh Việt Nam.Tiếp theo, chương này trình bày lợi nhuận kép trượt trên các kỳ hạn chuẩn (3, 6, 9 và 12 tháng), lợi nhuận kép được căn theo thời điểm kết thúc kỳ tài chính, lợi nhuận tích lũy hướng về phía trước dùng cho nghiên cứu sự kiện, và ước lượng độ biến động trượt.```{python}import pandas as pdimport numpy as npimport sqlite3import matplotlib.pyplot as pltfrom plotnine import*from mizani.formatters import percent_format, comma_format, date_formatfrom itertools import productfrom datetime import datetime, timedelta```## Lợi nhuận đơn giản và lợi nhuận logaritTrước khi bàn về việc tính lãi kép, chúng ta cần phân biệt hai quy ước lợi nhuận cơ bản được dùng trong tài chính.### Lợi nhuận đơn giản (số học)Lợi nhuận gộp đơn giản của một tài sản từ kỳ $t-1$ đến $t$ được định nghĩa là$$1 + R_t = \frac{P_t + D_t}{P_{t-1}},$$ {#eq-simple-return}trong đó $P_t$ là giá cuối kỳ $t$ và $D_t$ là mọi khoản phân phối bằng tiền mặt (cổ tức, lãi trái phiếu) được chi trả trong kỳ $t$. Lợi nhuận ròng đơn giản chính là $R_t$. Khi nói về "lợi nhuận" mà không nêu rõ, thông thường chúng ta hiểu đó là lợi nhuận ròng đơn giản.Tính chất then chốt của lợi nhuận đơn giản là **việc ghép lãi nhiều kỳ có dạng nhân**:$$1 + R_t(k) = \prod_{j=0}^{k-1} (1 + R_{t-j}) = (1 + R_t)(1 + R_{t-1}) \cdots (1 + R_{t-k+1}),$$ {#eq-compound-simple}trong đó $R_t(k)$ là lợi nhuận kép của $k$ kỳ kết thúc tại thời điểm $t$. Cấu trúc nhân này là nền tảng của mọi phương pháp tính lãi kép được trình bày trong chương này.### Lợi nhuận ghép lãi liên tục (logarit)Lợi nhuận ghép lãi liên tục, hay lợi nhuận logarit, được định nghĩa là$$r_t = \ln(1 + R_t) = \ln\!\left(\frac{P_t + D_t}{P_{t-1}}\right).$$ {#eq-log-return}Ưu điểm chính của lợi nhuận logarit khi tính lãi kép là **việc ghép lãi nhiều kỳ trở thành phép cộng**:$$r_t(k) = \ln(1 + R_t(k)) = \sum_{j=0}^{k-1} r_{t-j} = r_t + r_{t-1} + \cdots + r_{t-k+1}.$$ {#eq-compound-log}Tính chất cộng này suy ra trực tiếp từ đồng nhất thức logarit $\ln(ab) = \ln(a) + \ln(b)$. Nó thuận tiện về mặt tính toán vì phép cộng ổn định về số học hơn so với phép nhân lặp, và vì nhiều thủ tục thống kê (trung bình, phương sai, hồi quy) vận hành một cách tự nhiên trên các đại lượng có tính cộng.Để khôi phục lợi nhuận kép đơn giản từ tổng các lợi nhuận logarit, chúng ta áp dụng hàm mũ:$$R_t(k) = \exp\!\left(\sum_{j=0}^{k-1} r_{t-j}\right) - 1.$$ {#eq-recover-simple}### Khi nào hai loại lợi nhuận phân kỳ?Với lợi nhuận nhỏ, xấp xỉ $r_t \approx R_t$ đúng đến bậc một (qua khai triển Taylor $\ln(1+x) \approx x$ với $|x| \ll 1$). Tuy nhiên, với lợi nhuận lớn, điều thường gặp ở các thị trường mới nổi, cổ phiếu vốn hóa nhỏ hoặc giai đoạn khủng hoảng, hai loại lợi nhuận có thể chênh lệch đáng kể. Xét một cổ phiếu tăng giá gấp đôi ($R_t = 1.0$): lợi nhuận logarit là $r_t = \ln(2) \approx 0.693$, lệch 31%. Ngược lại, với cổ phiếu mất một nửa giá trị ($R_t = -0.5$): lợi nhuận logarit là $r_t = \ln(0.5) \approx -0.693$, lớn hơn 39% về độ lớn.Sự phân kỳ này đặc biệt đáng chú ý ở Việt Nam, nơi biên độ giá hằng ngày $\pm 7\%$ trên HOSE, $\pm 10\%$ trên HNX và $\pm 15\%$ trên UPCoM có thể tạo ra chuỗi các phiên giá trần hoặc giá sàn liên tiếp. Trong một tuần có các phiên giá trần liên tiếp trên HOSE, lợi nhuận đơn giản là $(1.07)^5 - 1 = 40.3\%$ trong khi lợi nhuận logarit là $5 \times \ln(1.07) = 33.8\%$, một khoảng chênh lệch đáng kể.@tbl-return-comparison minh họa sự phân kỳ này trên một dải các độ lớn lợi nhuận.```{python}#| label: tbl-return-comparison#| tbl-cap: "So sánh lợi nhuận đơn giản và lợi nhuận logarit với các mức thay đổi giá khác nhau. Độ chênh lệch tăng theo độ lớn của lợi nhuận đơn giản, điều đặc biệt quan trọng đối với các cổ phiếu biến động mạnh của thị trường mới nổi."simple_returns = [-0.50, -0.30, -0.15, -0.10, -0.07, -0.05, -0.01,0.00, 0.01, 0.05, 0.07, 0.10, 0.15, 0.30, 0.50, 1.00]comparison_df = pd.DataFrame({"Simple Return": [f"{r:.2%}"for r in simple_returns],"Log Return": [f"{np.log(1+r):.4f}"for r in simple_returns],"Difference": [f"{np.log(1+r) - r:.4f}"for r in simple_returns],"Relative Error (%)": [f"{((np.log(1+r) - r) /abs(r) *100):.2f}"if r !=0else"—"for r in simple_returns ]})comparison_df```> **Điểm mấu chốt**: lợi nhuận logarit thuận tiện cho việc tính lãi kép (cộng gộp), nhưng lợi nhuận danh mục được tổng hợp theo mặt cắt ngang trong không gian lợi nhuận đơn giản. Trong thực tế, chúng ta thường chuyển sang lợi nhuận logarit để ghép lãi theo thời gian, rồi quy đổi trở lại lợi nhuận đơn giản để báo cáo.## Nền tảng toán học của việc tính lãi kép### Lợi nhuận trung bình nhânLợi nhuận trung bình nhân trên $T$ kỳ là$$\bar{R}_g = \left(\prod_{t=1}^{T} (1 + R_t)\right)^{1/T} - 1,$$ {#eq-geometric-mean}đại lượng này biểu diễn mức lợi nhuận không đổi mỗi kỳ sẽ cho cùng giá trị tài sản cuối kỳ như chuỗi lợi nhuận thực tế. Nó luôn nhỏ hơn hoặc bằng trung bình cộng $\bar{R}_a = \frac{1}{T}\sum_{t=1}^{T} R_t$, và chỉ bằng nhau khi mọi lợi nhuận đều giống nhau. Mối quan hệ xấp xỉ giữa hai đại lượng là:$$\bar{R}_g \approx \bar{R}_a - \frac{\sigma^2}{2},$$ {#eq-arithmetic-geometric}trong đó $\sigma^2$ là phương sai của lợi nhuận. Xấp xỉ này, đôi khi được gọi là "lực cản biến động" (volatility drag), có hàm ý quan trọng: các tài sản có độ biến động cao có khoảng cách lớn hơn giữa trung bình cộng và trung bình nhân, nghĩa là mức tăng trưởng kép thực tế thấp hơn so với những gì một giá trị trung bình giản đơn gợi ra. Ở một thị trường như Việt Nam, nơi độ biến động của từng cổ phiếu thường gấp hai đến ba lần so với cổ phiếu ở các thị trường phát triển, lực cản biến động có thể đáng kể.### Chỉ số tài sản và mức sụt giảmVới khoản đầu tư ban đầu $W_0$, giá trị tài sản tại thời điểm $T$ là$$W_T = W_0 \prod_{t=1}^{T} (1 + R_t).$$ {#eq-wealth-index}Lợi nhuận tích lũy (ròng) đơn giản là $W_T / W_0 - 1$. Mức sụt giảm tối đa (maximum drawdown), một thước đo rủi ro được dùng rộng rãi, được định nghĩa là$$\text{MDD} = \max_{0 \le s \le t \le T} \left(\frac{W_s - W_t}{W_s}\right),$$ {#eq-max-drawdown}đại lượng này đo mức giảm lớn nhất từ đỉnh xuống đáy của chỉ số tài sản. Chúng ta sẽ tính đại lượng này cùng với lợi nhuận kép ở phần sau. Mức sụt giảm đặc biệt hữu ích ở các thị trường mới nổi chịu những đợt điều chỉnh mạnh, như đã xảy ra trong cuộc khủng hoảng tài chính toàn cầu năm 2008 khi VN-Index giảm khoảng 66% so với đỉnh năm 2007.<!--# Show the data here -->### Quy đổi theo nămVới lợi nhuận kép $k$ kỳ $R_t(k)$ trong đó mỗi kỳ có độ dài $\Delta$ (ví dụ $\Delta = 1/12$ với dữ liệu hằng tháng), lợi nhuận quy đổi theo năm là$$R_{\text{ann}} = (1 + R_t(k))^{1/(k\Delta)} - 1.$$ {#eq-annualize}Tương tự, với độ biến động ước lượng từ lợi nhuận $k$ kỳ có độ dài kỳ $\Delta$:$$\sigma_{\text{ann}} = \sigma / \sqrt{\Delta},$$ {#eq-annualize-vol}do đó độ biến động hằng tháng được quy đổi theo năm bằng cách nhân với $\sqrt{12}$ và độ biến động hằng ngày xấp xỉ nhân với $\sqrt{252}$ (giả định có 252 ngày giao dịch mỗi năm). Riêng với Việt Nam, HOSE thường có khoảng 245–250 ngày giao dịch mỗi năm sau khi trừ các ngày nghỉ lễ, đủ gần để quy ước $\sqrt{252}$ vẫn là chuẩn mực.## Chuẩn bị dữ liệuChúng ta bắt đầu bằng việc tải dữ liệu lợi nhuận cổ phiếu hằng tháng từ cơ sở dữ liệu SQLite. Như đã chuẩn bị ở các chương trước, cơ sở dữ liệu này chứa lợi nhuận hằng tháng lấy từ [DataCore.vn](https://datacore.vn/) cho mọi chứng khoán niêm yết trên Sở Giao dịch Chứng khoán TP. Hồ Chí Minh (HOSE), Sở Giao dịch Chứng khoán Hà Nội (HNX) và thị trường giao dịch của các công ty đại chúng chưa niêm yết (UPCoM). Lợi nhuận đã được điều chỉnh theo chia tách cổ phiếu, cổ phiếu thưởng và phát hành quyền mua, đồng thời bao gồm cổ tức tiền mặt tái đầu tư.```{python}tidy_finance = sqlite3.connect(database="data/tidy_finance_python.sqlite")prices_monthly = pd.read_sql_query( sql=""" SELECT symbol, date, ret_excess, ret, mktcap, mktcap_lag, risk_free FROM prices_monthly """, con=tidy_finance, parse_dates=["date"]).dropna()factors_ff3_monthly = pd.read_sql_query( sql="SELECT date, mkt_excess FROM factors_ff3_monthly", con=tidy_finance, parse_dates=["date"])prices_monthly = prices_monthly.merge( factors_ff3_monthly, on="date", how="left")prices_monthly["ret_total"] = prices_monthly["ret"]prices_monthly["mkt_total"] = ( prices_monthly["mkt_excess"] + prices_monthly["risk_free"])```Chúng ta hãy xem xét mẫu dữ liệu:```{python}print(f"Sample period: {prices_monthly['date'].min()} to "f"{prices_monthly['date'].max()}")print(f"Number of stocks: {prices_monthly['symbol'].nunique():,}")print(f"Total observations: {len(prices_monthly):,}")# print(f"Exchanges: {prices_monthly['exchange'].unique()}")```@tbl-sample-overview cung cấp thống kê mô tả cho lợi nhuận hằng tháng thô, phân theo sàn giao dịch. Sự khác biệt giữa các sàn phản ánh sự phân tầng về quy mô và thanh khoản: HOSE niêm yết các doanh nghiệp lớn nhất và thanh khoản nhất, HNX bao gồm các công ty vốn hóa trung bình, còn UPCoM là nơi giao dịch các chứng khoán nhỏ hơn và kém thanh khoản hơn.```{python}#| label: tbl-sample-overview#| eval: false#| tbl-cap: "Thống kê mô tả lợi nhuận cổ phiếu hằng tháng theo sàn giao dịch. Các doanh nghiệp trên HOSE có xu hướng có độ phân tán lợi nhuận thấp hơn và ít quan sát cực đoan hơn so với HNX và UPCoM, phù hợp với vốn hóa thị trường lớn hơn và thanh khoản cao hơn."sample_stats = ( prices_monthly .groupby("exchange")["ret_total"] .describe(percentiles=[0.05, 0.25, 0.50, 0.75, 0.95]) .round(4))sample_stats```## Phương pháp 1: Tích lũy kế bằng GroupByCách trực tiếp nhất để tính lợi nhuận kép là dùng tính chất nhân trong @eq-compound-simple. Với mỗi chứng khoán, chúng ta tính tích lũy kế của các lợi nhuận gộp $(1 + R_t)$ trên cửa sổ mong muốn.```{python}def compute_cumret_cumprod(df, ret_col="ret_total", group_col="symbol"):"""Compute cumulative returns using cumulative product. Parameters ---------- df : pd.DataFrame Must contain `group_col`, 'date', and `ret_col`. ret_col : str Column name for period returns. group_col : str Column name for grouping (e.g., security identifier). Returns ------- pd.DataFrame Original DataFrame augmented with 'cumret' and 'wealth_index'. """ df = df.sort_values([group_col, "date"]).copy() df["gross_ret"] =1+ df[ret_col] df["wealth_index"] = ( df.groupby(group_col)["gross_ret"] .cumprod() ) df["cumret"] = df["wealth_index"] -1 df.drop(columns=["gross_ret"], inplace=True)return df```Chúng ta hãy áp dụng cách này cho toàn bộ mẫu và xem xét các chỉ số tài sản thu được của một vài cổ phiếu được chọn:```{python}stock_cumret = compute_cumret_cumprod(prices_monthly)# Select stocks with long histories for illustrationstock_counts = ( stock_cumret.groupby("symbol")["date"] .count() .reset_index(name="n_obs"))long_history_stocks = ( stock_counts.nlargest(5, "n_obs")["symbol"].tolist())sample_wealth = stock_cumret[ stock_cumret["symbol"].isin(long_history_stocks)]```@fig-wealth-index vẽ các chỉ số tài sản (giá trị của 1 VND đầu tư) của năm chứng khoán này trong toàn bộ giai đoạn mẫu.```{python}#| label: fig-wealth-index#| fig-cap: "Chỉ số tài sản (giá trị của 1 VND đầu tư) của một số cổ phiếu Việt Nam có lịch sử dài được chọn. Mỗi đường biểu diễn giá trị tích lũy của khoản đầu tư 1 VND vào một cổ phiếu, với toàn bộ cổ tức được tái đầu tư. Sự phân kỳ về tài sản cuối kỳ cho thấy sức mạnh của lãi kép trong các kỳ hạn dài."#| fig-alt: "Biểu đồ đường thể hiện mức tăng trưởng của 1 VND đầu tư vào năm cổ phiếu Việt Nam khác nhau theo thời gian."#| fig-pos: "htbp"plot_wealth = ( ggplot(sample_wealth, aes(x="date", y="wealth_index", color="factor(symbol)")) + geom_line(size=0.6) + labs( x="", y="Wealth index (1 VND invested)", color="Stock" ) + theme_minimal() + theme(legend_position="bottom", figure_size=(10, 5)))plot_wealth.draw()```### Xử lý lợi nhuận bị thiếuCách tính tích lũy kế lan truyền giá trị thiếu: nếu bất kỳ $R_t$ nào là `NaN`, toàn bộ tích lũy kế từ thời điểm đó trở đi sẽ thành `NaN`. Cách này thận trọng vì về thực chất giả định rằng một lợi nhuận bị thiếu khiến chỉ số tài sản sau đó không xác định được. Trong nhiều ứng dụng, đây là hành vi mong muốn vì lợi nhuận bị thiếu có thể cho thấy lỗi dữ liệu hoặc giai đoạn cổ phiếu không được giao dịch.Tuy nhiên, trên thị trường Việt Nam, lợi nhuận bị thiếu có thể phát sinh từ các đợt tạm ngừng giao dịch kéo dài. Ủy ban Chứng khoán Nhà nước (UBCKNN) và các sở giao dịch có thể đình chỉ giao dịch một cổ phiếu vì nhiều lý do quản lý, chẳng hạn chậm công bố báo cáo tài chính, thông báo tái cơ cấu doanh nghiệp đang chờ xử lý, hoặc nghi ngờ thao túng thị trường. Các đợt tạm ngừng này có thể kéo dài vài ngày, vài tuần, thậm chí vài tháng. Trong thời gian đó, giá trị của cổ phiếu không thay đổi (mức giá giao dịch cuối cùng vẫn là giá tham chiếu), nên việc coi lợi nhuận bị thiếu bằng không (tức là không có biến động giá) có thể phù hợp hơn việc lan truyền `NaN`.```{python}def compute_cumret_skipna(df, ret_col="ret_total", group_col="symbol"):"""Compute cumulative returns, treating missing returns as zero.""" df = df.sort_values([group_col, "date"]).copy() df["gross_ret"] =1+ df[ret_col].fillna(0) df["wealth_index"] = ( df.groupby(group_col)["gross_ret"] .cumprod() ) df["cumret"] = df["wealth_index"] -1 df.drop(columns=["gross_ret"], inplace=True)return df```::: callout-warningViệc coi lợi nhuận bị thiếu bằng không là một giả định có thể phù hợp hoặc không. Nếu lợi nhuận bị thiếu vì cổ phiếu bị tạm ngừng giao dịch thì giá trị bằng không có thể hợp lý. Nếu lợi nhuận bị thiếu do lỗi dữ liệu hoặc vì cổ phiếu thực sự không được giao dịch (ví dụ, đang chờ niêm yết lại sau một sự kiện doanh nghiệp), việc gán giá trị bằng không có thể gây ra thiên lệch. Hãy luôn tìm hiểu nguyên nhân của các giá trị bị thiếu trước khi quyết định cách xử lý.:::<!--# Tài liệu của DataCore.vn cung cấp các cờ cho từng loại đình chỉ giao dịch, có thể hỗ trợ quyết định này. -->## Phương pháp 2: Cách tiếp cận log-sum-expPhương pháp log-sum-exp khai thác tính chất cộng của lợi nhuận logarit (@eq-compound-log). Cách tiếp cận này đặc biệt hữu ích khi tính lợi nhuận kép trên các cửa sổ cố định (ví dụ, lợi nhuận hằng năm từ dữ liệu hằng tháng) vì phép cộng vừa hiệu quả về tính toán vừa ổn định về số học.```{python}def compute_cumret_logsum(df, ret_col="ret_total", group_col="symbol", date_col="date"):"""Compute cumulative returns using the log-sum-exp approach. Steps: 1. Transform to log returns: r_t = ln(1 + R_t) 2. Cumulative sum of log returns within each group 3. Exponentiate to recover simple cumulative return Parameters ---------- df : pd.DataFrame ret_col : str group_col : str date_col : str Returns ------- pd.DataFrame """ df = df.sort_values([group_col, date_col]).copy() df["log_ret"] = np.log(1+ df[ret_col]) df["cum_log_ret"] = ( df.groupby(group_col)["log_ret"].cumsum() ) df["wealth_index_log"] = np.exp(df["cum_log_ret"]) df["cumret_log"] = df["wealth_index_log"] -1 df.drop(columns=["log_ret", "cum_log_ret"], inplace=True)return df```Chúng ta hãy kiểm tra rằng hai phương pháp cho kết quả giống hệt nhau (đến độ chính xác dấu phẩy động):```{python}stock_both = compute_cumret_cumprod(prices_monthly)stock_both = compute_cumret_logsum(stock_both)# Compare on non-missing observationsmask = (stock_both["cumret"].notna()& stock_both["cumret_log"].notna())max_diff = (stock_both.loc[mask, "cumret"] - stock_both.loc[mask, "cumret_log"]).abs().max()print(f"Maximum absolute difference between methods: {max_diff:.2e}")```Chênh lệch ở mức epsilon máy ($\approx 10^{-15}$), xác nhận sự tương đương về số học.### Lợi nhuận kép theo từng kỳ cụ thểMột công việc phổ biến là tính lợi nhuận kép trong các kỳ lịch (tháng, quý, năm). Phương pháp log-sum-exp phù hợp một cách tự nhiên với phép tổng hợp theo nhóm:```{python}def compound_return_by_period(df, ret_col="ret_total", group_col="symbol", period="year"):"""Compute compound returns within calendar periods. Parameters ---------- df : pd.DataFrame Must contain 'date' and `ret_col`. period : str One of 'year', 'quarter', 'month'. Returns ------- pd.DataFrame with compound returns per group-period. """ df = df.copy() df["log_ret"] = np.log(1+ df[ret_col])if period =="year": df["period"] = df["date"].dt.yearelif period =="quarter": df["period"] = df["date"].dt.to_period("Q")elif period =="month": df["period"] = df["date"].dt.to_period("M") result = ( df.groupby([group_col, "period"]) .agg( cumret=("log_ret",lambda x: np.exp(x.sum()) -1 ), n_obs=("log_ret", "count"), n_miss=(ret_col, lambda x: x.isna().sum()), start_date=("date", "min"), end_date=("date", "max") ) .reset_index() )return result```@tbl-annual-returns trình bày lợi nhuận kép hằng năm cho một tập con các chứng khoán.```{python}#| label: tbl-annual-returns#| tbl-cap: "Lợi nhuận kép hằng năm của một số chứng khoán Việt Nam được chọn. Số quan sát hằng tháng không bị thiếu (n_obs) và số quan sát bị thiếu (n_miss) được báo cáo để đánh dấu các năm có thể không đầy đủ. Một cặp cổ phiếu-năm có n_obs thấp hơn đáng kể so với 12 cho thấy cổ phiếu chỉ được niêm yết trong một phần của năm hoặc bị tạm ngừng giao dịch kéo dài."annual_returns = compound_return_by_period( prices_monthly[ prices_monthly["symbol"].isin(long_history_stocks) ], period="year")recent_annual = ( annual_returns .sort_values(["symbol", "period"]) .groupby("symbol") .tail(5) .round(4))recent_annual.head(20)```::: callout-importantKhi số quan sát không bị thiếu (`n_obs`) nhỏ hơn 12 đối với lợi nhuận hằng năm, lợi nhuận kép chỉ phản ánh một phần của năm. Điều này thường xảy ra vào năm đầu và năm cuối của một chứng khoán niêm yết trên HOSE, HNX hoặc UPCoM, hoặc khi một cổ phiếu chuyển sàn (ví dụ, từ UPCoM lên HOSE khi đáp ứng điều kiện niêm yết). Người dùng cần quyết định giữ lại hay loại bỏ các quan sát không trọn năm này tùy theo thiết kế nghiên cứu của mình.:::## Phương pháp 3: Tính lãi kép lặp với logic giữ lạiTrong một số ứng dụng, chúng ta cần kiểm soát chi tiết cách các giá trị bị thiếu, sự kiện hủy niêm yết hay các điều kiện đặc biệt khác ảnh hưởng đến quá trình tính lãi kép. Cách tiếp cận lặp xử lý lần lượt từng quan sát, chuyển tiếp lợi nhuận tích lũy và áp dụng logic có điều kiện ở mỗi bước.```{python}def compute_cumret_iterative(df, ret_col="ret_total", group_col="symbol", handle_missing="carry"):"""Compute cumulative returns iteratively with flexible missing value handling. Parameters ---------- df : pd.DataFrame ret_col : str group_col : str handle_missing : str 'carry' : treat missing as zero return (carry forward) 'propagate' : propagate NaN (conservative) 'reset' : reset wealth index to 1 after missing spell Returns ------- pd.DataFrame """ df = df.sort_values([group_col, "date"]).copy() results = []for name, group in df.groupby(group_col): cumret =1.0 cumrets = []for _, row in group.iterrows(): ret = row[ret_col]if pd.notna(ret): cumret = cumret * (1+ ret)else:if handle_missing =="propagate": cumret = np.nanelif handle_missing =="reset": cumret =1.0# 'carry' does nothing (cumret unchanged) cumrets.append(cumret) group = group.copy() group["wealth_iter"] = cumrets group["cumret_iter"] = group["wealth_iter"] -1 results.append(group)return pd.concat(results, ignore_index=True)```::: callout-notePhương pháp lặp là chậm nhất trong bốn cách tiếp cận vì không tận dụng được các phép toán vector hóa của NumPy. Với bộ dữ liệu lớn, hãy ưu tiên Phương pháp 1 hoặc 2, trừ khi logic có điều kiện của Phương pháp 3 là thiết yếu. Trên một bộ dữ liệu có 1 triệu quan sát, Phương pháp 1 chạy trong khoảng 0.1 giây so với hơn 10 giây của Phương pháp 3.:::### So sánh các cách xử lý giá trị bị thiếuĐể minh họa sự khác biệt giữa ba chiến lược xử lý giá trị bị thiếu, hãy xét một cổ phiếu giả định có một lợi nhuận bị thiếu ở giữa lịch sử của nó:```{python}#| label: tbl-missing-comparison#| tbl-cap: "Tác động của các cách xử lý giá trị bị thiếu khác nhau lên lợi nhuận tích lũy. Chiến lược 'carry' giả định lợi nhuận bằng không cho các kỳ bị thiếu (phù hợp với tạm ngừng giao dịch); 'propagate' khiến mọi giá trị sau đó không xác định (thận trọng); 'reset' khởi động lại tích lũy kế sau chuỗi kỳ bị thiếu."example = pd.DataFrame({"symbol": [1]*6,"date": pd.date_range("2024-01-31", periods=6, freq="ME"),"ret_total": [0.05, 0.03, np.nan, 0.04, -0.02, 0.06]})carry = compute_cumret_iterative(example, handle_missing="carry")propagate = compute_cumret_iterative( example, handle_missing="propagate")reset = compute_cumret_iterative(example, handle_missing="reset")comparison = pd.DataFrame({"Date": example["date"].dt.strftime("%Y-%m"),"Return": example["ret_total"],"Carry": carry["cumret_iter"].round(6),"Propagate": propagate["cumret_iter"].round(6),"Reset": reset["cumret_iter"].round(6)})comparison```## Phương pháp 4: Lợi nhuận kép trượtVới nhiều ứng dụng thực nghiệm, gồm chiến lược động lượng, đánh giá hiệu quả đầu tư và ước lượng rủi ro, chúng ta cần lợi nhuận kép trên các cửa sổ trượt có độ dài cố định. Mục này triển khai việc tính lãi kép trượt hiệu quả bằng pandas.### Cửa sổ trượt qua lợi nhuận logaritCách hiệu quả nhất là kết hợp phương pháp log-sum-exp với tổng trượt:```{python}def rolling_compound_return(df, ret_col="ret_total", group_col="symbol", windows=[3, 6, 9, 12]):"""Compute rolling compound returns over specified windows. Parameters ---------- df : pd.DataFrame Must be sorted by [group_col, 'date'] with no gaps. ret_col : str group_col : str windows : list of int Rolling window lengths (in periods). Returns ------- pd.DataFrame with new columns ret_{k} for each window k. """ df = df.sort_values([group_col, "date"]).copy() df["log_ret"] = np.log(1+ df[ret_col])for k in windows: rolling_logsum = ( df.groupby(group_col)["log_ret"] .transform(lambda x: x.rolling( window=k, min_periods=k ).sum() ) ) df[f"ret_{k}"] = np.exp(rolling_logsum) -1 df.drop(columns=["log_ret"], inplace=True)return df```Chúng ta áp dụng cách này cho toàn bộ mẫu để tính lợi nhuận kép 3, 6, 9 và 12 tháng gần nhất:```{python}stock_rolling = rolling_compound_return( prices_monthly, windows=[3, 6, 9, 12])```Chúng ta cũng tính các lợi nhuận trượt tương tự cho chỉ số thị trường, đóng vai trò chuẩn so sánh khi tính lợi nhuận vượt mức:```{python}# Compute market rolling returnsmarket_monthly = ( prices_monthly[["date", "mkt_total"]] .drop_duplicates() .sort_values("date") .copy())market_monthly["log_mkt"] = np.log(1+ market_monthly["mkt_total"])for k in [3, 6, 9, 12]: market_monthly[f"mkt_{k}"] = ( np.exp( market_monthly["log_mkt"] .rolling(window=k, min_periods=k) .sum() ) -1 )market_monthly.drop(columns=["log_mkt"], inplace=True)# Merge market rolling returns backstock_rolling = stock_rolling.merge( market_monthly[ ["date"] + [f"mkt_{k}"for k in [3, 6, 9, 12]] ], on="date", how="left")```@fig-rolling-returns hiển thị phân phối của lợi nhuận kép trượt 12 tháng theo thời gian.```{python}#| label: fig-rolling-returns#| fig-cap: "Phân phối theo mặt cắt ngang của lợi nhuận kép trượt 12 tháng của các cổ phiếu Việt Nam theo thời gian. Dải tô bóng biểu diễn khoảng tứ phân vị (phân vị thứ 25 đến 75), còn đường liền thể hiện trung vị. Các sự kiện toàn thị trường mạnh, như khủng hoảng tài chính toàn cầu 2008 và cú sốc COVID-19 năm 2020, hiện rõ là những giai đoạn mà ngay cả lợi nhuận trung vị cũng chuyển sang âm mạnh."#| fig-alt: "Biểu đồ chuỗi thời gian thể hiện phân phối lợi nhuận cổ phiếu trượt 12 tháng ở Việt Nam."#| fig-pos: "htbp"rolling_stats = ( stock_rolling .dropna(subset=["ret_12"]) .groupby("date")["ret_12"] .agg(["median", lambda x: x.quantile(0.25),lambda x: x.quantile(0.75)]) .reset_index())rolling_stats.columns = ["date", "median", "p25", "p75"]plot_rolling = ( ggplot(rolling_stats, aes(x="date")) + geom_ribbon(aes(ymin="p25", ymax="p75"), alpha=0.3, fill="#2166ac") + geom_line(aes(y="median"), color="#2166ac", size=0.7) + geom_hline(yintercept=0, linetype="dashed") + labs(x="", y="12-month compound return") + scale_y_continuous(labels=percent_format()) + theme_minimal() + theme(figure_size=(10, 5)))plot_rolling.draw()```### Kiểm tra lợi nhuận trượtViệc kiểm tra lợi nhuận kép trượt bằng phép tính trực tiếp là điều nên làm. Chúng ta chọn một cổ phiếu và tính lại lợi nhuận 12 tháng của nó theo cách thủ công:```{python}#| label: tbl-rolling-verify#| tbl-cap: "Kiểm tra việc tính lợi nhuận kép trượt. Cột 'Direct' tính tích của 12 lợi nhuận gộp hằng tháng liền trước rồi trừ một; cột 'Rolling' dùng hàm log-sum-exp của chúng ta. Chênh lệch ở mức độ chính xác của máy."test_stock = long_history_stocks[0]test_data = ( stock_rolling[stock_rolling["symbol"] == test_stock] .sort_values("date") .tail(15) .copy())# Direct computationtest_data["direct_ret_12"] = ( test_data["ret_total"] .transform(lambda x: x.add(1).rolling(12, min_periods=12 ).apply(np.prod, raw=True) -1 ))verify = ( test_data[["date", "ret_12", "direct_ret_12"]] .dropna() .tail(5) .copy())verify["difference"] = ( verify["ret_12"] - verify["direct_ret_12"]).abs()verify.round(8)```## Lợi nhuận hủy niêm yết và thiên kiến sống sótMột vấn đề thực tiễn quan trọng khi tính lợi nhuận kép là cách xử lý các chứng khoán bị loại khỏi sàn giao dịch. Việc hủy niêm yết xảy ra vì nhiều lý do: sáp nhập và mua lại, phá sản, không đáp ứng điều kiện niêm yết, tự nguyện rút niêm yết, hoặc chuyển sang sàn khác. Nếu không đưa lợi nhuận hủy niêm yết vào, lợi nhuận kép thu được chịu thiên kiến sống sót: chúng phóng đại hiệu quả vì các kết quả tệ nhất (phá sản, bị buộc hủy niêm yết) bị loại ra [@shumway1997delisting].### Bối cảnh Việt NamỞ Việt Nam, chứng khoán có thể bị loại khỏi niêm yết trên sàn vì nhiều lý do theo quy định của UBCKNN và các sở giao dịch:- **Hủy niêm yết bắt buộc**: khi một doanh nghiệp có lỗ lũy kế vượt vốn điều lệ, không đáp ứng nghĩa vụ báo cáo tài chính trong ba năm liên tiếp, hoặc bị thu hồi giấy phép kinh doanh.- **Hủy niêm yết tự nguyện**: khi cổ đông của doanh nghiệp biểu quyết rút khỏi sàn giao dịch.- **Chuyển sàn**: khi một doanh nghiệp chuyển từ UPCoM lên HOSE/HNX (nâng cấp) hoặc từ HOSE/HNX xuống UPCoM (hạ cấp). Về mặt kinh tế, những lần chuyển sàn này không phải là hủy niêm yết thực sự nhưng đòi hỏi xử lý cẩn thận khi tính lợi nhuận.Khác với các thị trường phát triển hơn, nơi dữ liệu chi tiết về lợi nhuận hủy niêm yết được tổng hợp một cách có hệ thống, dữ liệu thị trường Việt Nam có thể không phải lúc nào cũng cung cấp lợi nhuận hủy niêm yết một cách tường minh. Khi một cổ phiếu bị hủy niêm yết do vi phạm hoặc hoàn cảnh bất lợi (ví dụ, phá sản), mức giá giao dịch cuối cùng có thể phóng đại đáng kể giá trị thu hồi của chứng khoán. Các nhà nghiên cứu cần nhận thức hạn chế này và cân nhắc gán lợi nhuận hủy niêm yết dựa trên lý do hủy niêm yết, theo phương pháp của @shumway1997delisting.### Đưa lợi nhuận hủy niêm yết vào tính toánKhi một chứng khoán bị hủy niêm yết, một "lợi nhuận hủy niêm yết" cuối cùng phản ánh sự thay đổi giá trị giữa ngày giao dịch thông thường cuối cùng và giá trị thực hiện được sau khi hủy niêm yết. Lợi nhuận này phải được kết hợp với lợi nhuận thông thường trong tháng hủy niêm yết:$$R_t^{\text{adj}} = (1 + R_t)(1 + R_t^{\text{delist}}) - 1,$$ {#eq-delisting-adj}trong đó $R_t$ là lợi nhuận thông thường và $R_t^{\text{delist}}$ là lợi nhuận hủy niêm yết. Nếu lợi nhuận thông thường bị thiếu (cổ phiếu ngừng giao dịch trước cuối tháng), chúng ta chỉ dùng lợi nhuận hủy niêm yết.```{python}def adjust_for_delisting(df, ret_col="ret_total", dlret_col="dlret"):"""Adjust returns for delisting events. Parameters ---------- df : pd.DataFrame Must contain `ret_col` and `dlret_col`. Returns ------- pd.DataFrame with adjusted return column 'ret_adj'. """ df = df.copy() df["ret_adj"] = df[ret_col]# Case 1: Both regular and delisting returns available mask_both = df[ret_col].notna() & df[dlret_col].notna() df.loc[mask_both, "ret_adj"] = ( (1+ df.loc[mask_both, ret_col]) * (1+ df.loc[mask_both, dlret_col]) -1 )# Case 2: Only delisting return available mask_dlret_only = ( df[ret_col].isna() & df[dlret_col].notna() ) df.loc[mask_dlret_only, "ret_adj"] = ( df.loc[mask_dlret_only, dlret_col] )return df```### Tác động của điều chỉnh hủy niêm yếtĐộ lớn của thiên lệch do hủy niêm yết phụ thuộc vào tần suất và mức độ nghiêm trọng của các sự kiện hủy niêm yết. @shumway1997delisting cho thấy rằng, ở các thị trường phát triển, việc bỏ qua lợi nhuận hủy niêm yết gây ra thiên lệch hướng lên khoảng 1% mỗi năm trong lợi nhuận danh mục trọng số bằng nhau. Thiên lệch này lớn hơn đối với cổ phiếu vốn hóa nhỏ và cổ phiếu giá trị, vốn dễ gặp khó khăn tài chính hơn. Ở Việt Nam, nơi các doanh nghiệp nhỏ hơn trên HNX và UPCoM chịu ràng buộc thanh khoản chặt hơn và rủi ro vỡ nợ cao hơn, thiên lệch có thể còn rõ rệt hơn. Trong các trường hợp hủy niêm yết ở thị trường mới nổi, hủy niêm yết bắt buộc thường liên quan đến các doanh nghiệp khó khăn tài chính nghiêm trọng, nơi giá trị vốn chủ sở hữu còn lại gần bằng không, hàm ý lợi nhuận hủy niêm yết gần $-100\%$ trong những trường hợp xấu nhất.## Ước lượng độ biến động trượtĐộ biến động của lợi nhuận cổ phiếu là đầu vào quan trọng cho quản trị rủi ro, định giá quyền chọn và nhiều mô hình định giá tài sản thực nghiệm. Một cách tiếp cận phổ biến là ước lượng độ lệch chuẩn trượt của lợi nhuận trên một cửa sổ các kỳ gần nhất.### Độ biến động trượt 24 thángTheo @ben2012hedge, chúng ta tính tổng độ biến động lợi nhuận cổ phiếu là độ lệch chuẩn trượt của lợi nhuận hằng tháng trên cửa sổ 24 tháng:$$\hat{\sigma}_{i,t}^{24} = \sqrt{\frac{1}{23}\sum_{j=0}^{23}(R_{i,t-j} - \bar{R}_{i,t}^{24})^2},$$ {#eq-rolling-vol}trong đó $\bar{R}_{i,t}^{24} = \frac{1}{24}\sum_{j=0}^{23} R_{i,t-j}$ là lợi nhuận trung bình 24 tháng gần nhất.```{python}def rolling_volatility(df, ret_col="ret_total", group_col="symbol", window=24):"""Compute rolling return volatility. Parameters ---------- df : pd.DataFrame ret_col : str group_col : str window : int Rolling window length in periods. Returns ------- pd.DataFrame with 'vol_{window}' column (annualized). """ df = df.sort_values([group_col, "date"]).copy() df[f"vol_{window}"] = ( df.groupby(group_col)[ret_col] .transform(lambda x: x.rolling( window=window, min_periods=window ).std() ) )# Annualize (monthly to annual) df[f"vol_{window}_ann"] = df[f"vol_{window}"] * np.sqrt(12)return df``````{python}stock_vol = rolling_volatility(stock_rolling)```@fig-vol-distribution cho thấy phân phối theo mặt cắt ngang của độ biến động 24 tháng quy đổi theo năm qua thời gian.```{python}#| label: fig-vol-distribution#| fig-cap: "Phân phối theo mặt cắt ngang của độ biến động lợi nhuận cổ phiếu trượt 24 tháng, quy đổi theo năm, của các cổ phiếu Việt Nam. Độ biến động trung vị (đường liền) và khoảng tứ phân vị (dải tô bóng) phản ánh cả các xu hướng dài hạn lẫn các giai đoạn khủng hoảng. Cổ phiếu Việt Nam có độ biến động cao hơn hẳn về mặt cấu trúc so với các thị trường phát triển, với độ biến động trung vị quy đổi theo năm thường nằm trong khoảng 30% đến 50%."#| fig-alt: "Chuỗi thời gian của phân phối theo mặt cắt ngang về độ biến động lợi nhuận cổ phiếu ở Việt Nam."#| fig-pos: "htbp"vol_stats = ( stock_vol .dropna(subset=["vol_24_ann"]) .groupby("date")["vol_24_ann"] .agg(["median", lambda x: x.quantile(0.25),lambda x: x.quantile(0.75)]) .reset_index())vol_stats.columns = ["date", "median", "p25", "p75"]plot_vol = ( ggplot(vol_stats, aes(x="date")) + geom_ribbon(aes(ymin="p25", ymax="p75"), alpha=0.3, fill="#b2182b") + geom_line(aes(y="median"), color="#b2182b", size=0.7) + labs(x="", y="Annualized 24-month volatility") + scale_y_continuous(labels=percent_format()) + theme_minimal() + theme(figure_size=(10, 5)))plot_vol.draw()```### Biến động và lợi nhuận kép: Sự hao hụt do phương saiNhư đã nêu trong @eq-arithmetic-geometric, lợi nhuận trung bình nhân thấp hơn trung bình cộng khoảng $\sigma^2/2$. "Sự hao hụt do phương sai" hay "lực cản biến động" này có nghĩa là hai danh mục có cùng lợi nhuận trung bình cộng nhưng độ biến động khác nhau sẽ có lợi nhuận kép khác nhau: danh mục có độ biến động thấp hơn sẽ tăng trưởng kép đến mức tài sản cuối kỳ lớn hơn.Hiệu ứng này có tầm quan trọng định lượng ở Việt Nam. Một cổ phiếu có lợi nhuận trung bình cộng hằng tháng là 1.5% và độ lệch chuẩn hằng tháng là 10% chịu lực cản biến động khoảng $0.10^2/2 = 0.5\%$ mỗi tháng, tức xấp xỉ 6% mỗi năm. Điều này phù hợp với quan sát rằng nhà đầu tư Việt Nam chịu sự bào mòn đáng kể đối với mức tăng trưởng kép của tài sản do độ biến động đặc thù cao của từng cổ phiếu. Chúng ta có thể kiểm chứng thực nghiệm điều này bằng cách phân cổ phiếu thành các nhóm ngũ phân vị theo độ biến động và so sánh lợi nhuận kép:```{python}#| label: tbl-vol-drag#| tbl-cap: "Trung bình cộng, trung bình nhân và độ biến động theo ngũ phân vị độ biến động của các cổ phiếu Việt Nam. Chênh lệch giữa trung bình cộng và trung bình nhân tăng theo độ biến động, xác nhận hiệu ứng hao hụt do phương sai. Lực cản biến động lớn rõ rệt ở nhóm có độ biến động cao nhất, điển hình của các cổ phiếu nhỏ và kém thanh khoản trên HNX và UPCoM."annual_data = compound_return_by_period( prices_monthly, period="year")annual_data = annual_data[annual_data["n_obs"] >=10].copy()vol_annual = ( prices_monthly .groupby(["symbol", prices_monthly["date"].dt.year])["ret_total" ] .agg(["std", "mean", "count"]) .reset_index())vol_annual.columns = ["symbol", "period", "monthly_std","monthly_mean", "n_months"]vol_annual = vol_annual[vol_annual["n_months"] >=10].copy()vol_annual["ann_vol"] = vol_annual["monthly_std"] * np.sqrt(12)vol_annual["arith_mean_ann"] = vol_annual["monthly_mean"] *12vol_analysis = annual_data.merge( vol_annual, on=["symbol", "period"])vol_analysis["vol_quintile"] = ( vol_analysis.groupby("period")["ann_vol"] .transform(lambda x: pd.qcut( x, 5, labels=[1, 2, 3, 4, 5], duplicates="drop" ) ))vol_summary = ( vol_analysis .groupby("vol_quintile") .agg( arithmetic_mean=("arith_mean_ann", "mean"), geometric_mean=("cumret", "mean"), avg_volatility=("ann_vol", "mean"), n_stockyears=("cumret", "count") ) .round(4) .reset_index())vol_summary```## Lợi nhuận kép quanh thời điểm kết thúc năm tài chínhMột cách tiếp cận được dùng rộng rãi trong nghiên cứu kế toán và tài chính là căn lợi nhuận kép theo ngày kết thúc kỳ tài chính riêng của từng doanh nghiệp. Điều này thiết yếu để tính lợi nhuận bất thường mua và nắm giữ (BHAR) cho nghiên cứu sự kiện, trôi dạt lợi nhuận sau công bố kết quả kinh doanh (PEAD) và các nghiên cứu khác mà ngày xảy ra sự kiện khác nhau giữa các doanh nghiệp.Ở Việt Nam, phần lớn doanh nghiệp niêm yết áp dụng năm tài chính theo năm dương lịch (tháng 1 đến tháng 12), theo yêu cầu của Luật Kế toán trừ khi Bộ Tài chính chấp thuận ngoại lệ. Tuy nhiên, các doanh nghiệp trong một số ngành (ví dụ nông nghiệp, du lịch) có thể dùng năm tài chính không chuẩn kết thúc vào tháng 3, tháng 6 hoặc tháng 9.<!--# Cơ sở dữ liệu báo cáo tài chính của DataCore.vn ghi nhận ngày kết thúc năm tài chính riêng của từng doanh nghiệp theo từng năm. -->### Căn lợi nhuận theo kỳ tài chínhThách thức chính là ngày kết thúc năm tài chính khác nhau giữa các doanh nghiệp. Chúng ta cần tính lợi nhuận kép trên các cửa sổ neo vào những ngày riêng của từng doanh nghiệp này.```{python}def compound_returns_around_event( returns_df, events_df, id_col="symbol", date_col="date", event_date_col="datadate", ret_col="ret_total", pre_windows=[3, 6, 9, 12], post_windows=[3, 6]):"""Compute compound returns in windows around firm-specific event dates. Parameters ---------- returns_df : pd.DataFrame Monthly returns with [id_col, date_col, ret_col]. events_df : pd.DataFrame Event dates with [id_col, event_date_col]. pre_windows : list of int Trailing window lengths (months before event). post_windows : list of int Forward window lengths (months after event). Returns ------- pd.DataFrame with compound returns for each window. """ returns_df = returns_df.sort_values( [id_col, date_col] ).copy() events_df = events_df.copy()# Align event dates to month ends events_df["event_month"] = ( pd.to_datetime(events_df[event_date_col])+ pd.offsets.MonthEnd(0) ) results = []for _, event in events_df.iterrows(): sid = event[id_col] edate = event["event_month"] sec_rets = returns_df[ returns_df[id_col] == sid ].copy() sec_rets = sec_rets.set_index(date_col)[ret_col] row = {id_col: sid, event_date_col: event[event_date_col]}# Pre-event compound returnsfor k in pre_windows: start = edate - pd.DateOffset(months=k-1) start = (start - pd.offsets.MonthEnd(0)+ pd.offsets.MonthEnd(0)) window_rets = sec_rets[ (sec_rets.index >= start)& (sec_rets.index <= edate) ]iflen(window_rets) >= k *0.8: cumret = ( np.exp(np.log(1+ window_rets).sum()) -1 )else: cumret = np.nan row[f"ret_pre_{k}"] = cumret# Post-event compound returnsfor k in post_windows: start = edate + pd.DateOffset(months=1) end = (edate + pd.DateOffset(months=k)+ pd.offsets.MonthEnd(0)) window_rets = sec_rets[ (sec_rets.index >= start)& (sec_rets.index <= end) ]iflen(window_rets) >= k *0.8: cumret = ( np.exp(np.log(1+ window_rets).sum()) -1 )else: cumret = np.nan row[f"ret_post_{k}"] = cumret results.append(row)return pd.DataFrame(results)```### Lợi nhuận bất thường mua và nắm giữ so với lợi nhuận bất thường tích lũyVới nghiên cứu sự kiện và đánh giá hiệu quả đầu tư, chúng ta thường muốn có lợi nhuận kép **vượt mức**, tức là lợi nhuận kép của cổ phiếu trừ đi lợi nhuận kép của chuẩn so sánh trên cùng cửa sổ. Lợi nhuận bất thường mua và nắm giữ (BHAR) được định nghĩa là$$\text{BHAR}_{i,t}(k) = \prod_{j=1}^{k}(1 + R_{i,t+j}) - \prod_{j=1}^{k}(1 + R_{b,t+j}),$$ {#eq-bhar}trong đó $R_{b,t}$ là lợi nhuận của chuẩn so sánh (chỉ số thị trường, danh mục khớp theo quy mô, v.v.). Điều này khác với lợi nhuận bất thường tích lũy (CAR), vốn cộng các lợi nhuận bất thường đơn giản:$$\text{CAR}_{i,t}(k) = \sum_{j=1}^{k}(R_{i,t+j} - R_{b,t+j}).$$ {#eq-car}BHAR phản ánh tốt hơn trải nghiệm thực tế của nhà đầu tư vì nó thể hiện việc ghép lãi của lợi nhuận, trong khi CAR ngầm giả định tái cân bằng hằng ngày để duy trì các vị thế giá trị bằng nhau trong cổ phiếu và chuẩn so sánh [@barber1997detecting]. Sự phân biệt này đặc biệt quan trọng ở Việt Nam, nơi lợi nhuận của từng cổ phiếu có thể biến động mạnh nên hiệu ứng ghép lãi bị khuếch đại. @lyon1999improved phân tích sâu hơn các tính chất thống kê của BHAR và khuyến nghị dùng giá trị tới hạn bootstrap cho suy luận thống kê.```{python}def compute_bhar(stock_returns, benchmark_returns):"""Compute buy-and-hold abnormal return. Parameters ---------- stock_returns : array-like Sequence of stock returns. benchmark_returns : array-like Sequence of benchmark returns (same length). Returns ------- float : BHAR """ stock_cumret = ( np.prod(1+ np.array(stock_returns)) -1 ) bench_cumret = ( np.prod(1+ np.array(benchmark_returns)) -1 )return stock_cumret - bench_cumret```## Giá trị sổ sách của vốn chủ sở hữuNhiều ứng dụng thực nghiệm dùng lợi nhuận kép cũng cần các biến kế toán cấp doanh nghiệp. Một biến thường dùng là giá trị sổ sách của vốn chủ sở hữu, được tính theo @daniel1997evidence:$$\text{BE} = \text{SE} + \text{DT} + \text{ITC} - \text{PS},$$ {#eq-book-equity}trong đó SE là vốn chủ sở hữu, DT là thuế hoãn lại, ITC là tín dụng thuế đầu tư và PS là giá trị cổ phiếu ưu đãi. Với cổ phiếu ưu đãi, thứ tự ưu tiên là: giá trị mua lại nếu có, sau đó là giá trị thanh lý, rồi đến giá trị ghi sổ.In Vietnam, the accounting standards (Vietnamese Accounting Standards, VAS, and increasingly IFRS adoption) provide a somewhat different chart of accounts. Stockholders' equity is reported on the balance sheet as *Vốn chủ sở hữu*, which includes contributed capital (*Vốn góp của chủ sở hữu*), share premium (*Thặng dư vốn cổ phần*), treasury stock adjustments, retained earnings (*Lợi nhuận sau thuế chưa phân phối*), and other reserves. Deferred tax assets and liabilities are reported separately. Preferred stock is rare among Vietnamese listed firms (most issue only common shares), but when present, its book value should be subtracted from total equity.```{python}def compute_book_equity(df):"""Compute book value of equity for Vietnamese firms. Parameters ---------- df : pd.DataFrame Must contain at minimum: equity (stockholders' equity), deferred_tax (deferred tax liabilities, net), pref_stock (preferred stock, if applicable). Returns ------- pd.DataFrame with 'be' column. """ df = df.copy() df["pref"] = df.get("pref_stock", pd.Series(0, index=df.index) ) df["dt"] = df.get("deferred_tax", pd.Series(0, index=df.index) ) df["be"] = ( df["equity"].fillna(0)+ df["dt"].fillna(0)- df["pref"].fillna(0) )# Set non-positive book equity to NaN df.loc[df["be"] <=0, "be"] = np.nanreturn df```## Mức sụt giảm tối đaMức sụt giảm tối đa là một thước đo rủi ro quan trọng bổ sung cho độ biến động. Trong khi độ biến động đo độ phân tán của lợi nhuận một cách đối xứng, mức sụt giảm tối đa nắm bắt khoản lỗ tích lũy tồi tệ nhất mà nhà đầu tư có thể phải chịu: một thước đo phù hợp hơn với cách nhà đầu tư cảm nhận rủi ro về mặt tâm lý [@kahneman2013prospect].```{python}def compute_max_drawdown(df, ret_col="ret_total", group_col="symbol"):"""Compute maximum drawdown for each security. Parameters ---------- df : pd.DataFrame ret_col : str group_col : str Returns ------- pd.DataFrame with 'max_drawdown' and running drawdown. """ df = df.sort_values([group_col, "date"]).copy() df["gross_ret"] =1+ df[ret_col] df["wealth"] = ( df.groupby(group_col)["gross_ret"].cumprod() ) df["peak"] = df.groupby(group_col)["wealth"].cummax() df["drawdown"] = ( (df["wealth"] - df["peak"]) / df["peak"] ) max_dd = ( df.groupby(group_col)["drawdown"] .min() .reset_index(name="max_drawdown") ) df = df.merge(max_dd, on=group_col) df.drop(columns=["gross_ret"], inplace=True)return df```@fig-drawdown minh họa diễn biến sụt giảm của một cổ phiếu được chọn.```{python}#| label: fig-drawdown#| fig-cap: "Hồ sơ sụt giảm của một cổ phiếu Việt Nam được chọn, thể hiện mức giảm phần trăm so với đỉnh cao nhất tính đến từng thời điểm. Mức sụt giảm tối đa (đường nét đứt nằm ngang) biểu diễn khoản lỗ từ đỉnh xuống đáy tồi tệ nhất trong toàn bộ mẫu. Cổ phiếu Việt Nam thường xuyên có mức sụt giảm vượt 50%, phản ánh độ biến động cao của thị trường và tính dễ bị tổn thương trước các đợt điều chỉnh do tâm lý."#| fig-alt: "Biểu đồ chuỗi thời gian về mức sụt giảm của một cổ phiếu Việt Nam."#| fig-pos: "htbp"dd_data = compute_max_drawdown( prices_monthly[ prices_monthly["symbol"] == long_history_stocks[0] ])mdd = dd_data["max_drawdown"].iloc[0]plot_dd = ( ggplot(dd_data, aes(x="date", y="drawdown")) + geom_area(fill="#b2182b", alpha=0.4) + geom_line(color="#b2182b", size=0.5) + geom_hline(yintercept=mdd, linetype="dashed") + labs(x="", y="Drawdown from peak") + scale_y_continuous(labels=percent_format()) + theme_minimal() + theme(figure_size=(10, 4)))plot_dd.draw()```## Tổng hợp lại: Một quy trình xử lý toàn diệnBây giờ chúng ta kết hợp tất cả các phương pháp thành một quy trình duy nhất tạo ra bộ dữ liệu sẵn sàng cho nghiên cứu, với lợi nhuận kép trượt, lợi nhuận thị trường, độ biến động và các thước đo sụt giảm.```{python}def build_compound_return_dataset( stock_df, windows=[3, 6, 9, 12], vol_window=24):"""Build comprehensive compound return dataset. Parameters ---------- stock_df : pd.DataFrame Monthly stock return data with columns: symbol, date, ret_total, mkt_total. windows : list of int Rolling compound return windows. vol_window : int Rolling volatility window. Returns ------- pd.DataFrame """ df = stock_df.sort_values(["symbol", "date"]).copy()# Step 1: Log returns df["log_ret"] = np.log(1+ df["ret_total"]) df["log_mkt"] = np.log(1+ df["mkt_total"])# Step 2: Rolling compound returns (stock and market)for k in windows: df[f"ret_{k}"] = np.exp( df.groupby("symbol")["log_ret"] .transform(lambda x: x.rolling(k, min_periods=k).sum() ) ) -1 df[f"mkt_{k}"] = np.exp( df["log_mkt"] .rolling(k, min_periods=k) .sum() ) -1# Excess compound return (BHAR vs market) df[f"exret_{k}"] = df[f"ret_{k}"] - df[f"mkt_{k}"]# Step 3: Cumulative return (full history) df["wealth"] = ( df.groupby("symbol")["log_ret"] .cumsum() .apply(np.exp) ) df["cumret"] = df["wealth"] -1# Step 4: Rolling volatility df[f"vol_{vol_window}"] = ( df.groupby("symbol")["ret_total"] .transform(lambda x: x.rolling( vol_window, min_periods=vol_window ).std() ) ) * np.sqrt(12) # annualize# Step 5: Drawdown df["peak"] = df.groupby("symbol")["wealth"].cummax() df["drawdown"] = (df["wealth"] - df["peak"]) / df["peak"]# Clean up df.drop( columns=["log_ret", "log_mkt", "peak"], inplace=True )return df``````{python}# Build the full datasetcompound_dataset = build_compound_return_dataset(prices_monthly)```@tbl-summary-stats cung cấp thống kê mô tả cho các biến chính trong bộ dữ liệu lợi nhuận kép của chúng ta.```{python}#| label: tbl-summary-stats#| tbl-cap: "Thống kê mô tả các biến lợi nhuận kép trên toàn bộ các quan sát cổ phiếu-tháng của Việt Nam. Lợi nhuận ở dạng thập phân (0.10 = 10%). Độ phân tán rộng của lợi nhuận kép 12 tháng và độ biến động trung vị cao phản ánh đặc điểm thị trường mới nổi của thị trường cổ phiếu Việt Nam."summary_cols = ["ret_total", "ret_3", "ret_6", "ret_12","exret_3", "exret_12", "vol_24", "drawdown"]available_cols = [c for c in summary_colsif c in compound_dataset.columns]summary = ( compound_dataset[available_cols] .describe(percentiles=[0.05, 0.25, 0.50, 0.75, 0.95]) .T .round(4))summary```## Phân phối theo mặt cắt ngang của lợi nhuận képĐể hiểu lợi nhuận kép khác nhau thế nào giữa các chứng khoán, chúng ta xem xét phân phối theo mặt cắt ngang ở các kỳ hạn khác nhau.```{python}#| label: fig-horizon-comparison#| fig-cap: "Phân phối theo mặt cắt ngang của lợi nhuận kép ở các kỳ hạn khác nhau (3, 6 và 12 tháng) của các cổ phiếu Việt Nam. Kỳ hạn dài hơn có độ phân tán lớn hơn và độ lệch phải rõ rệt hơn, phản ánh việc ghép lãi của rủi ro đặc thù. Các đuôi dày cực đoan hơn so với thường thấy ở các thị trường phát triển, phù hợp với môi trường biến động cao hơn."#| fig-alt: "Các biểu đồ mật độ chồng lên nhau của lợi nhuận kép ở các kỳ hạn 3, 6 và 12 tháng của các cổ phiếu Việt Nam."#| fig-pos: "htbp"horizon_data = pd.DataFrame()for k in [3, 6, 12]: col =f"ret_{k}" temp = compound_dataset[[col]].dropna().copy() temp.columns = ["compound_return"] temp["horizon"] =f"{k} months" lo, hi = temp["compound_return"].quantile([0.01, 0.99]) temp = temp[ (temp["compound_return"] >= lo)& (temp["compound_return"] <= hi) ] horizon_data = pd.concat([horizon_data, temp])plot_horizons = ( ggplot(horizon_data, aes(x="compound_return", fill="horizon")) + geom_density(alpha=0.4) + geom_vline(xintercept=0, linetype="dashed") + labs(x="Compound return", y="Density", fill="Horizon") + scale_x_continuous(labels=percent_format()) + theme_minimal() + theme(legend_position="bottom", figure_size=(10, 5)))plot_horizons.draw()```## Những lưu ý riêng của Việt Nam### Biên độ giá và tác động lên việc tính lãi képCác sở giao dịch chứng khoán Việt Nam áp đặt biên độ giá hằng ngày, giới hạn mức thay đổi giá tối đa so với giá tham chiếu. Theo các quy định mới nhất:- **HOSE**: $\pm 7\%$- **HNX**: $\pm 10\%$- **UPCoM**: $\pm 15\%$Các giới hạn này cắt cụt phân phối lợi nhuận hằng ngày và có thể tạo ra chuỗi các phiên chạm biên độ khi có sự kiện thông tin lớn. Với việc tính lợi nhuận kép, điều này có nghĩa là sự điều chỉnh theo thông tin mới có thể trải ra nhiều ngày thay vì diễn ra tức thời. Khi tính lợi nhuận kép hằng tháng từ dữ liệu hằng ngày, điều này được xử lý đúng vì lợi nhuận kép tích lũy toàn bộ mức điều chỉnh bất kể mất bao nhiêu ngày.Tuy nhiên, biên độ giá có thể gây ra thiên lệch trong việc tính lợi nhuận ở kỳ hạn ngắn. Nếu một sự kiện tích cực lớn xảy ra và cổ phiếu chạm giá trần trong nhiều ngày liên tiếp, lợi nhuận kép 1 ngày hoặc 1 tuần sẽ đánh giá thấp nội dung thông tin thực sự của sự kiện [@kim2013reconsidering]. Với các ứng dụng nghiên cứu sự kiện, nhà nghiên cứu cần kiểm tra rằng cửa sổ sự kiện đủ dài để bao hàm độ trễ điều chỉnh giá do biên độ giá gây ra.### Giới hạn sở hữu nước ngoàiViệt Nam áp đặt giới hạn sở hữu nước ngoài (FOL) đối với các công ty niêm yết, thường tối đa 49% với hầu hết các ngành và thấp hơn (30% hoặc ít hơn) với một số lĩnh vực hạn chế như ngân hàng và viễn thông. Khi một cổ phiếu đã đạt FOL, nhà đầu tư nước ngoài chỉ có thể mua cổ phiếu từ những người bán là nhà đầu tư nước ngoài khác, tạo ra một thị trường song song có phần bù giá đối với cổ phiếu của khối ngoại. Điều này không trực tiếp ảnh hưởng đến việc tính lợi nhuận kép (vốn dùng giá giao dịch chính thức), nhưng các nhà nghiên cứu về lợi nhuận danh mục xuyên biên giới nên lưu ý rằng mức giá thực tế nhà đầu tư nước ngoài phải trả có thể khác với giá trên bảng giá [@vo2017foreign].### VN-Index và các chuẩn so sánh thị trườngĐối với lợi nhuận kép của chuẩn so sánh, các chỉ số chính của Việt Nam là:- **VN-Index**: Chỉ số trọng số theo vốn hóa của tất cả cổ phiếu niêm yết trên HOSE.- **VN30**: 30 cổ phiếu lớn nhất và thanh khoản nhất trên HOSE, được xem xét định kỳ sáu tháng một lần.- **HNX-Index**: Chỉ số trọng số theo vốn hóa của các cổ phiếu niêm yết trên HNX.VN-Index là chuẩn so sánh được dùng rộng rãi nhất và là lợi nhuận thị trường mặc định trong bộ dữ liệu của chúng ta.## Các cân nhắc về hiệu năngKhi làm việc với bộ dữ liệu lớn, hiệu quả tính toán rất quan trọng. @tbl-performance-benchmark so sánh thời gian thực thi của bốn phương pháp tính lãi kép trên một bộ dữ liệu chuẩn hóa.```{python}#| label: tbl-performance-benchmark#| tbl-cap: "So sánh thời gian thực thi của các phương pháp tính lãi kép khác nhau trên bộ dữ liệu 10,000 quan sát cổ phiếu-tháng. Các phương pháp tích lũy kế và log-sum-exp nhanh hơn nhiều bậc so với cách tiếp cận lặp nhờ vector hóa của NumPy."import timenp.random.seed(42)n_stocks =100n_months =100test_df = pd.DataFrame({"symbol": np.repeat(range(n_stocks), n_months),"date": np.tile( pd.date_range("2015-01-31", periods=n_months, freq="ME"), n_stocks ),"ret_total": np.random.normal(0.01, 0.08, n_stocks * n_months )})methods = {}t0 = time.time()_ = compute_cumret_cumprod(test_df)methods["Cumulative Product"] = time.time() - t0t0 = time.time()_ = compute_cumret_logsum(test_df)methods["Log-Sum-Exp"] = time.time() - t0t0 = time.time()_ = compute_cumret_iterative(test_df)methods["Iterative (carry)"] = time.time() - t0t0 = time.time()_ = rolling_compound_return(test_df, windows=[12])methods["Rolling (12-month)"] = time.time() - t0perf_df = pd.DataFrame({"Method": methods.keys(),"Time (seconds)": [f"{v:.4f}"for v in methods.values()],"Relative Speed": [f"{v/min(methods.values()):.1f}x"for v in methods.values() ]})perf_df```## Các lỗi thường gặp và thông lệ tốt nhấtMột số vấn đề tinh tế có thể dẫn đến tính sai lợi nhuận kép. Chúng ta tóm tắt những vấn đề quan trọng nhất:**Khoảng trống trong chuỗi thời gian.** Nếu một chứng khoán có những tháng không có quan sát (thậm chí không có cả cờ đánh dấu lợi nhuận bị thiếu), các phép tính cửa sổ trượt dựa trên chỉ mục theo vị trí sẽ cho kết quả sai. Cửa sổ trượt sẽ bao phủ sai kỳ lịch. Hãy luôn bảo đảm chuỗi thời gian đầy đủ, điền các khoảng trống bằng giá trị thiếu tường minh trước khi tính các thống kê trượt. Điều này đặc biệt đáng lưu ý ở Việt Nam, nơi các đợt đình chỉ giao dịch có thể tạo ra khoảng trống.**Thiên kiến sống sót.** Như đã thảo luận trong mục về lợi nhuận hủy niêm yết, việc loại bỏ các chứng khoán ngừng giao dịch làm lợi nhuận kép bị thiên lệch hướng lên. Hãy luôn đưa lợi nhuận hủy niêm yết vào khi có sẵn. Khi không có lợi nhuận hủy niêm yết (như đôi khi xảy ra với dữ liệu Việt Nam), hãy cân nhắc dùng các giá trị gán dựa trên lý do hủy niêm yết.**Thiên lệch nhìn trước.** Khi căn lợi nhuận kép theo ngày kết thúc năm tài chính cho phân tích theo mặt cắt ngang, cần cẩn thận không dùng lợi nhuận trước ngày kết thúc năm tài chính để dự báo lợi nhuận sau công bố. Các doanh nghiệp Việt Nam phải công bố báo cáo tài chính năm đã kiểm toán trong vòng 90 ngày kể từ ngày kết thúc năm tài chính, do đó nên có khoảng đệm ít nhất 3 tháng khi xây dựng lợi nhuận kép hướng về phía trước.**Tràn số trên và tràn số dưới.** Với các kỳ hạn ghép lãi rất dài hoặc lợi nhuận cực đoan, tích lũy kế có thể bị tràn số trên (`inf`) hoặc tràn số dưới (0). Phương pháp log-sum-exp vững hơn trước các vấn đề số học như vậy vì nó vận hành trong không gian logarit, nơi miền giá trị được nén lại.**Quy đổi theo năm của các kỳ không trọn vẹn.** Khi tính lợi nhuận quy đổi theo năm từ dữ liệu của kỳ không trọn vẹn (ví dụ, 7 tháng dữ liệu quy đổi lên 12 tháng), công thức quy đổi $(1+R)^{12/k} - 1$ giả định rằng tốc độ lợi nhuận quan sát được sẽ tiếp tục duy trì. Giả định này càng mạnh với các kỳ không trọn vẹn ngắn và có thể cho kết quả gây hiểu lầm. Hãy báo cáo lợi nhuận kép thực tế và số kỳ cùng với mọi con số quy đổi theo năm.**Chuyển sàn.** Ở Việt Nam, cổ phiếu đôi khi chuyển giữa UPCoM, HNX và HOSE. Những lần chuyển sàn này có thể kèm theo tạm ngừng giao dịch và có thể gây ra các khoảng trống biểu kiến trong chuỗi lợi nhuận. Khi tính lợi nhuận kép trải qua một lần chuyển sàn, hãy bảo đảm chuỗi lợi nhuận liên tục qua ngày chuyển sàn.<!-- ## Bài tập1. Tính lợi nhuận kép hằng năm của VN-Index cho từng năm trong mẫu. Kết quả này so với tổng đơn giản của các lợi nhuận hằng tháng ra sao? Năm nào chênh lệch lớn nhất, và vì sao?2. Xây dựng một hàm tính **tỷ số Calmar** (lợi nhuận quy đổi theo năm chia cho giá trị tuyệt đối của mức sụt giảm tối đa) cho từng chứng khoán. Những chứng khoán nào có tỷ số Calmar cao nhất trong giai đoạn 5 năm gần nhất? Chúng có xu hướng thuộc HOSE, HNX hay UPCoM?3. Phân cổ phiếu thành các nhóm ngũ phân vị dựa trên lợi nhuận kép 12 tháng gần nhất (tín hiệu động lượng) và tính lợi nhuận trung bình trọng số bằng nhau của từng nhóm trong tháng kế tiếp. Hiệu ứng động lượng có xuất hiện trong dữ liệu Việt Nam không? So sánh kết quả của bạn với bằng chứng từ @vo2018does.4. Mở rộng hàm `rolling_compound_return` để xử lý các năm tài chính chồng lấn, trong đó cửa sổ ghép lãi được căn theo ngày kết thúc năm tài chính của từng doanh nghiệp thay vì theo tháng dương lịch.5. So sánh các thước đo BHAR và CAR cho một tập các ngày sự kiện được chọn ngẫu nhiên. Trong điều kiện nào chúng phân kỳ nhiều nhất? Liên hệ kết quả của bạn với phần thảo luận lý thuyết của @barber1997detecting.6. Tính tương quan theo mặt cắt ngang giữa độ biến động trượt 24 tháng và lợi nhuận kép 12 tháng tiếp theo. Có sự đánh đổi giữa rủi ro và lợi nhuận trong mặt cắt ngang của thị trường cổ phiếu Việt Nam không? Điều này so sánh thế nào với mối quan hệ rủi ro-lợi nhuận dương được ghi nhận ở các thị trường phát triển bởi @ghysels2005there?7. Xem xét biên độ giá hằng ngày ảnh hưởng thế nào đến việc tính lợi nhuận kép hằng tuần. Chọn các cổ phiếu chạm giá trần hoặc giá sàn ít nhất một ngày, và so sánh lợi nhuận kép hằng tuần của chúng với các sự kiện có độ lớn tương tự ở các cổ phiếu không chạm biên độ. -->